A pile of electronic components sitting on top of each other

類似投稿

  • | | | |

    AIが当たり前の日常に!私たちが知っておくべき「新常識」とは?

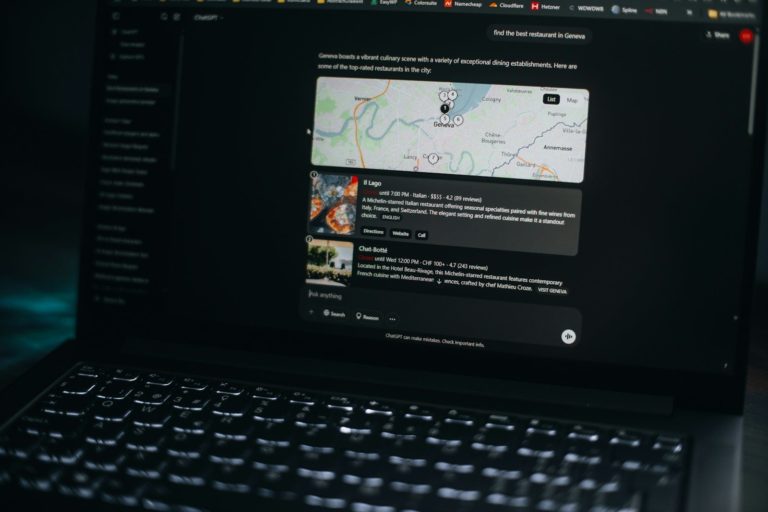
    AIが「選べるオプション」だった時代は終わったもう自分から人工知能(AI)を探しに行く必要なんてありません。向こうから勝手にやってきたんですから。検索バー、メールの下書き、そして写真のギャラリー。今起きているのは、AIが「すごい見せ物」から「便利な日用品」へと静かに移り変わるプロセスです。ほとんどの人は、自分から望んでこの変化を受け入れたわけではありません。ソフトウェアのアップデートや利用規約の変更と一緒に、いつの間にかやってきたんです。私たちは今、情報との接し方が根本から作り直される瞬間に立ち会っています。これからのゴールは「ウェブサイトを見つける手助け」ではなく「直接答えを出すこと」に変わります。このシフトはインターネットの本質そのものを変えてしまいます。「図書館モデル」から「アシスタントモデル」への移行です。これは未来の話ではなく、スマホやPCを使っているすべての人にとっての「今」の基準なのです。人間とマシンの出力の境界線が消えつつある世界で、自分を見失わないためには、この変化を理解することが不可欠です。この新しい現実を詳しく知るには、The AI Magazineで最新の動向をチェックしてみてください。 静かに、でも確実に進む「マシンの知能」の融合今やAIは、あらゆるものの土台になっています。検索エンジンでは、リンクが並ぶ前に自動生成された要約が表示されます。オフィスソフトでは、サイドバーが「会議のまとめやメモの下書きをしましょうか?」と提案してきます。スマホはメールの返信を考え、顔認識で写真の中の人物を特定するのが当たり前になりました。この統合は意図的なものです。企業は単体のチャットボットから脱却し、AIをワークフローの中に「見えない存在」として組み込もうとしています。つまり、気づかないうちにこれらのツールを使っているということです。迷惑メールをブロックするフィルターや、ニュースの表示順を決めるアルゴリズムの中にもAIはいます。これは「自動化された推論」が日常化しているということ。詩を書いたりアートを作ったりするだけではなく、ソフトウェアが行う毎日何百もの小さな判断に関わっているのです。その結果、私たちはスピードと効率に対して新しい期待を持つようになりました。タスクに数秒以上かかると、「なぜアルゴリズムがやってくれないんだろう?」と不思議に思うほどです。この感覚が、これからのデジタル体験のスタート地点になります。私たちは「手動入力」の世界から「意図」の世界へと移りつつあります。やりたいことをコンピューターに伝えれば、あとは勝手にやってくれる。これはユーザー体験における劇的な変化であり、多くの人がまだ消化しきれていない部分でもあります。これは「白紙の恐怖」の終焉であり、マシンが最初の下書きを作ってくれる時代の幕開けなのです。 世界の情報秩序がガラリと変わるこの変化の影響は、テック業界だけにとどまりません。世界中で起きています。発展途上国では、言語の壁を越えたり、プログラミングの基礎を学んだりするためにこれらのツールが使われています。しかし、そこには新たな格差も生まれています。システムをうまく使いこなすプロンプトのコツを知っている人と、そうでない人の間に大きな差がつくからです。また、情報の信頼性の問題もあります。テキストや画像を簡単に生成できるようになったことで、フェイク情報を作るコストはゼロになりました。これは選挙や各国の公的信頼に影響を与えます。Reutersのレポートによると、合成メディアの台頭により、ニュースの事実確認はすでに困難になりつつあります。世界中で規制の動きがありますが、テクノロジーの進化は法律よりもずっと速いのが現実です。仕事が奪われることを心配する人も多いでしょう。確かに役割は変わりますが、これからはキーボードが打てるのと同じくらい、**AIリテラシー**が必須のスキルになります。これは労働のグローバルな再編です。単純な知的作業を繰り返す人よりも、マシンを管理できる人が重宝されるようになります。これは欧米だけの現象ではなく、記録的な速さで世界標準になりつつあります。あらゆる業界が、競争に勝ち残るためにAIの導入を急いでいます。その結果、デフォルトの出力が「純粋に人間だけのもの」ではない世界がやってくるのです。 自動化された日常、ある火曜日の風景マーケティングマネージャーのサラさんの、ある火曜日を想像してみてください。彼女は朝起きてメールをチェックします。スマホはすでにメッセージを「重要」と「ジャンク」に仕分け済み。彼女はワンタップの提案返信を使って、会議の予定を確定させます。通勤中にはポッドキャストを聴きますが、そのショーノート(概要)は音声を聴いて要点をまとめたAIが作成したものです。職場ではスプレッドシートを開きますが、もう関数を書く必要はありません。やりたいことを普通の言葉で伝えれば、ソフトが表を組み立ててくれます。ランチの店を探すときも、検索エンジンが何十ものレビューを読み込んで要約してくれるので、自分で読み漁る必要はありません。午後のプレゼン資料作成では、箇条書きのメモをスライド作成ソフトに渡すだけで、画像付きのフルセットが完成します。SNSのフィードでさえ、彼女がスクロールし続けたくなるものを完璧に理解したシステムによってキュレーションされています。これが「新しい日常」の一日です。便利ですが、それは「選択の委譲」の連続でもあります。サラは、自分が完全には理解していないシステムに判断を任せているのです。帰宅途中、銀行から電話がかかってきました。聞き覚えのある、プロフェッショナルな声です。しかし実は、それは詐欺に使われたボイスクローンでした。これが同じテクノロジーの裏側です。朝の便利さは、夜の新しいリスクと隣り合わせなのです。このシフトは全般的です。彼女の一日の中で、自動化システムの影響を受けていない部分は一つもありません。Wiredが指摘するように、現実と合成の境界が曖昧になることこそが、現代の決定的な課題です。サラはテックマニアではありません。ただ普通に生活しているだけですが、彼女の体験は今や何十億人もの人々のスタンダードになりつつあります。 BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 「絶え間ないアシスト」に隠された代償この便利さと引き換えに、私たちは何を差し出しているのでしょうか?モデルを訓練するデータの所有権は誰にあるのか。プライベートなメールをアシスタントに書かせたら、あなたの話し方のトーンはその企業のものになってしまうのか。効率化には隠れたコストがあります。巨大なデータセンターを動かすためのエネルギー消費は膨大です。要約されたメール一通に、それだけの環境負荷をかける価値はあるのでしょうか?また、正確性の問題も無視できません。システムが素早く答えを出すとき、元のソースにあった微妙なニュアンスや文脈は切り捨てられがちです。私たちは賢くなっているのでしょうか、それとも「無知であることに自信を持っている」だけなのでしょうか?また、要約だけで満足してユーザーがサイトを訪れなくなったら、元のコンテンツを作ったクリエイターはどうなるのでしょう。これは一種の「デジタルな搾取」です。さらに、基礎スキルの低下も懸念されます。自分で文章を書かず、調べ物もしなくなったら、批判的思考力は失われてしまうのでしょうか?これらは単なる技術的な問題ではなく、スピードを優先するあまり無視されている社会的・倫理的なジレンマです。MIT Technology Reviewの研究によれば、人間の認知能力への長期的な影響はまだわかっていません。私たちは、対照群のない巨大な社会実験に参加しているようなものです。便利さは「釣り針」であり、その代償は私たちの注意力とデータです。その取引が本当に公平なのか、問い直す必要があります。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 現代の「推論インフラ」の裏側カーテンの裏側を覗いてみたい人のために、技術的な現実についても触れておきましょう。こうした統合の多くは、クラウド上の大規模モデルへのAPI呼び出しに依存しています。これは、少数の大手プロバイダーへの依存を生みます。各やり取りには「トークン制限」があり、システムが一度に処理できる情報量が決まっています。プライバシーを重視するパワーユーザーは、ローカルストレージやローカルモデルに注目し始めています。特定のタスクに特化した新しいチップの登場により、自分のハードウェアで小規模言語モデルを動かすことが現実味を帯びてきました。これなら、外部サーバーにデータを送らずにワークフローを構築できます。ただし、ローカルモデルはクラウド版に比べて推論能力が劣ることが多いのも事実です。また、APIのレート制限(回数制限)をうまく管理しないと、自動化されたワークフローが止まってしまうこともあります。「コンテキストウィンドウ」の理解も重要です。データを詰め込みすぎると、システムは会話の初期の内容を忘れてしまいます。長文のドキュメント分析が失敗しやすいのはこのためです。これからのパワーユーザーの主流は、ハイブリッドシステムになるでしょう。単純なタスクはローカルで、複雑な推論はクラウドで行う形です。ワークフローを構築する際の重要ポイントは以下の通りです:トークン管理と、1,000インタラクションあたりのコスト。リアルタイムタスクにおけるリモートサーバー呼び出しのレイテンシ(遅延)。データプライバシーと、履歴を残さない「ゼロリテンションAPI」の活用。長い会話におけるコンテキストウィンドウの限界。今後は、最適化へと焦点が移っていくでしょう。単なるチャット画面のフェーズはもう終わりです。次は、ソフトウェアがアプリをまたいであなたの代わりにアクションを起こす「エージェント型ワークフロー」がやってきます。これには、今よりもはるかに高い信頼性とセキュリティが必要です。また、モデルがどう「失敗」するかを理解することも重要です。AIは従来のソフトのようにエラーを出すのではなく、「自信満々に間違える」ことで失敗します。これがいわゆる「ハルシネーション(幻覚)」問題で、最新システムでも依然として課題です。こうしたエラーを管理することこそが、現代のパワーユーザーの主要な仕事になります。 「見えないアシスタント」と生きていく新しい日常とは、特定の製品やアプリのことではありません。テクノロジーとの関係性が根本から変わるということです。「コンピューターに何をすべきか指示する世界」から、「何をしたいか伝える世界」への変化です。このシフトは驚異的な効率をもたらしますが、同時に新しいレベルの懐疑心も求められます。私たちは、与えられた情報を検証し、統合が進む時代の中でプライバシーを守る術を学ばなければなりません。目標はこれらのツールを恐れることではなく、その役割を正しく理解することです。AIはアシスタントであり、人間の判断に取って代わるものではありません。これから最も価値のあるスキルは、AIを使いこなす能力ではなく、「いつAIのスイッチを切るべきかを知る能力」になるでしょう。「AIの新常識」はすでに定着しています。私たちは、批判的な視点を失うことなく、この新しい存在に適応していかなければなりません。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。
  • | | | |

    2026年を決定づけるAIの10の潮流

    生成AIツールのハネムーン期間は終わりを迎えようとしています。2026年までに、焦点はチャットインターフェースの目新しさから、それを支える基盤インフラへと移るでしょう。私たちは、ソフトウェアが何を語るかではなく、それがどのように駆動され、誰がモデルの重みを所有し、データがどこに保管されているかが最大の関心事となる時代に突入しています。業界は、情報が世界中でどのように処理・配信されるかという構造的なシフトに向かっています。もはや実験的なボットの話ではありません。機械知能がインターネットの根幹や物理的な電力網に統合される段階にあるのです。投資家やユーザーは、初期の興奮を通り越し、運用コストの増大や現在のハードウェアの限界に目を向け始めています。今後数ヶ月を支配するストーリーラインは、こうした根本的な制約に対処するものとなるでしょう。私たちは、中央集権的なクラウドの支配から、より断片化され専門化された環境へと移行しています。勝者となるのは、膨大なエネルギー需要と、トレーニングデータを巡る複雑化する法規制環境を管理できる企業です。 機械知能における構造的シフト最初の大きな潮流は、モデルパワーの集中です。現在、少数の企業が最先端のフロンティアモデルを支配しています。これはイノベーションのボトルネックを生んでおり、小規模なプレイヤーはこれら独自のシステムの上に構築せざるを得ません。しかし、組織が独自のハードウェアで高性能なシステムを実行できる「オープンウェイトモデル」への後押しが見られます。クローズドとオープンのシステム間の緊張関係は、企業が高いサブスクリプション料金を支払うか、自前のインフラに投資するかを決断する段階で限界点に達するでしょう。同時に、ハードウェア市場も多様化しています。長年チップ市場を独占してきた企業がある一方で、競合他社や主要クラウドプロバイダーによる自社シリコンプロジェクトが代替案を提供し始めています。このサプライチェーンの変化は、推論コストを削減し、一般的なビジネスにおいて大規模なデプロイをサステナブルにするために不可欠です。もう一つの重要な進展は、検索の破壊です。数十年間、検索バーはインターネットへの入り口でした。今や、直接回答エンジンが従来のリンクのリストに取って代わろうとしています。これはウェブの経済学を変えるものです。ユーザーがAIから完全な回答を得られれば、ソースウェブサイトをクリックする理由がなくなります。これは、トラフィックを収益源とするパブリッシャーやコンテンツクリエイターにとっての危機です。また、ローカルでのAI実行の台頭も見られます。すべてのクエリをリモートサーバーに送信する代わりに、ノートPCやスマホに搭載された新しいプロセッサが、プライベートで高速、かつオフラインでの処理を可能にします。このエッジへの動きは、低レイテンシーへのニーズと、データプライバシーへの高まる需要の両方に突き動かされています。組織は、機密性の高い企業データをサードパーティのクラウドに送ることが重大なリスクであり、ローカルのハードウェアソリューションで軽減すべきだと認識し始めています。 自動化システムが世界に与える影響これらの技術の影響は、テック業界を遥かに超えています。政府は現在、AI能力を国家安全保障の問題として扱っています。これにより、各国が国内でのチップ生産を確保するために数十億ドルを投資する「シリコン主権」の競争が起きています。ライバルが最先端のハードウェアにアクセスできないようにするための厳格な輸出管理や貿易ブロックも見られます。この地政学的な緊張は、規制の場にも反映されています。欧州連合や米国の各機関は、モデルのトレーニングやデプロイを管理するためのルールを起草中です。これらの規制は、透明性、バイアス、そして金融やヘルスケアといった重要分野での悪用の可能性に焦点を当てています。目標は、成長を許容しつつ、自動意思決定による最も危険な結果を防ぐフレームワークを作ることです。エネルギー圧力は、業界の静かなる危機です。データセンターによる電力需要は、かつてない速さで増加すると予測されています。これにより、テック企業は自らエネルギー供給者となり、サーバーを稼働させるために原子力発電や巨大なソーラーファームに投資せざるを得なくなっています。地域によっては、電力網が需要に追いつかず、データセンター建設の遅延を招いています。これは、テック企業がどこに拠点を置くかという地理的なシフトを生み出し、安価で豊富な電力がある地域が選ばれるようになっています。さらに、軍事コンテキストでの自動化システムの利用も加速しています。自律型ドローンから戦略分析ツールまで、機械知能の防衛システムへの統合は、紛争の性質を変えつつあります。これは、致死的な決定における人間の監督の役割や、自動化された戦争シナリオにおける急速なエスカレーションの可能性について、緊急の倫理的問いを投げかけています。 現実世界への統合と日常生活2026年の典型的な一日において、専門家は朝、スマホ上のローカルモデルが生成した夜間の通信要約を確認することから始めるかもしれません。これはデータがデバイスの外に出ることなく行われるため、個人のスケジュールやクライアント名が安全に保たれます。会議中、専門化されたエージェントが会話を聞き取り、リアルタイムで社内データベースと議論を照合するかもしれません。このエージェントは単に書き起こすだけではありません。プロジェクトのタイムラインにおける矛盾を特定し、過去の成功したワークフローに基づいて解決策を提案します。これが、ソフトウェアが受動的なアシスタントから作業プロセスの能動的な参加者へと変わる「エージェント的シフト」の現実です。 BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 焦点は、一般的な会話ではなく、狭い範囲での高い信頼性が求められるタスクに置かれています。この移行により、管理業務に費やす時間は削減されますが、従業員にはこれらのシステムの出力を管理するプレッシャーが増大します。メディアや情報への影響も同様に深刻です。ディープフェイクは、単純な顔の入れ替えを超え、現実と見分けがつかないほどの高精細な動画や音声へと進化しました。これがデジタルコンテンツに対する信頼の危機を招いています。これに対抗するため、信頼できるメディアには暗号署名を採用する動きが見られます。スマホで撮影されたすべての写真や動画に、その起源を証明するデジタル透かしが間もなく付与されるかもしれません。この真正性を巡る戦いは、ジャーナリズム、政治、エンターテインメントに関わるすべての人にとって主要なストーリーラインです。消費者はオンラインで見聞きするものに対してより懐疑的になっており、信頼できるブランドや検証済みのソースの価値が再評価されています。情報の検証コストは上昇しており、合成メディアの時代に確実性を提供できる者が大きな力を持つことになるでしょう。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 労働市場への影響も考慮しなければなりません。一部の仕事は置き換えられていますが、他の仕事は変革されています。最も顕著な動きは中間管理職層で見られ、AIがスケジューリング、レポーティング、基本的なパフォーマンス追跡を処理できるようになっています。これは、人間のリーダーシップがどのようなものであるべきかの再評価を迫るものです。価値は、感情的知性、複雑な問題解決、倫理的判断へとシフトしています。労働者はデジタルエージェントの艦隊を監督することを求められており、新しい技術的・管理的スキルセットが必要となっています。この変化は教育システムが適応するよりも速く進んでおり、企業が社内トレーニングプログラムで埋めようとしているタレントギャップを生み出しています。これらのツールを効果的に使える人と使えない人の間の分断は拡大しており、政府がようやく対処し始めたばかりの新しい形の経済的不平等へとつながっています。 ソクラテス的な懐疑論と隠れたコスト私たちは、この急速な導入の真のコストが何であるかを問わなければなりません。もし私たちが認知インフラを3〜4社の主要企業に依存しているなら、彼らの利益が公共の利益と乖離したとき、何が起こるのでしょうか?知能の集中は、ほとんど議論されていないリスクです。私たちはローカルでの制御をクラウドベースの利便性と引き換えにしていますが、その利便性の代償は、プライバシーの完全な喪失と、いつでも変更可能なサブスクリプションモデルへの依存です。データそのものについての問題もあります。ほとんどのモデルは、人類の文化の集合的な成果物でトレーニングされています。企業がその価値を捕捉し、元のクリエイターに報酬を支払うことなく私たちに売り戻すことは倫理的でしょうか?著作権を巡る現在の法廷闘争は、情報の所有権に関するより大きな議論の始まりに過ぎません。私たちは、これらのシステムの短期的な能力を過大評価し、長期的な構造的影響を過小評価する傾向があります。人々はどんな問題でも解決できる汎用知能を期待していますが、私たちが得ているのは、既存のソフトウェアに統合された、非常に効率的で狭い範囲のツールです。危険なのは暴走する機械ではなく、クレジットスコア、求人応募、医療処置について決定を下す、理解の及ばないアルゴリズムです。私たちは、機械の論理がそれを使う人間にとって不透明な世界を構築しています。なぜ特定の結論に至ったのかを説明できないシステムに対し、どうやって責任を問えばよいのでしょうか?これらは単なる技術的な問題ではありません。社会がどのように機能すべきかという根本的な問いです。私たちは、効率性の向上が、透明性と人間の主体性の喪失に見合う価値があるかどうかを決定しなければなりません。 パワーユーザー向けセクションこれらのシステムを構築・管理する人々にとって、焦点はワークフロー統合とローカル最適化に移っています。巨大なAPIを呼び出すだけの時代は、洗練されたオーケストレーション層に取って代わられつつあります。パワーユーザーは現在、以下の技術的制約に注目しています:APIのレート制限と、ロングコンテキストモデルのためのトークンウィンドウのコスト。精度を大幅に損なうことなく、コンシューマーグレードのハードウェアで大規模モデルを実行するための量子化の利用。モデルが最新の社内データにアクセスできるようにするためのRAG(検索拡張生成)の実装。高速かつプライベートな情報検索のためのローカルベクトルデータベースの管理。ワークフロー自動化は、もはや単純なトリガーではありません。複数のモデルを連鎖させ、小さく高速なモデルが初期ルーティングを処理し、より大きく有能なモデルが複雑な推論を処理するような構成を含みます。この階層型アプローチは、コストとレイテンシーを管理するために不可欠です。また、すべての新しいコンピューティングデバイスにおいて、NPU(ニューラルプロセッシングユニット)のような専門ハードウェアが標準化される動きも見られます。これにより、OSのバックグラウンドで実行される持続的で低電力なAI機能が可能になります。開発者にとっての課題は、単にコードを書くことではなく、これらのシステムを微調整するために使用されるデータのライフサイクルを管理することです。これらの基礎的なメカニズムを理解している20パーセントのユーザーが、次世代のソフトウェアアーキテクチャを決定づけることになるでしょう。NVMeストレージの速度が、大規模モデルの重みをメモリにロードするためのボトルネックになりつつあります。多くの推論タスクにおいて、メモリ帯域幅は純粋な計算能力よりも重要です。特定のタスクにおいて、古い大規模モデルと同等の性能を発揮する小規模言語モデル(SLM)の台頭。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 結論今後2年間は、実用主義への移行によって定義されるでしょう。業界は「素早く動き、破壊せよ」というメンタリティから、信頼性が高く、スケーラブルで倫理的なシステムを構築するための、より規律あるアプローチへと移行しています。ローカルハードウェア、専門化されたモデル、厳格な法規制遵守が標準となる新しいスタックの出現を私たちは目にしています。重要なストーリーラインは、最新のチャットボットのデモではなく、これらのツールを私たちの世界の物理的・法的構造に統合するという地道な作業についてです。成功はモデルの複雑さではなく、エンドユーザーに提供する有用性と安全性によって測定されるでしょう。誇大広告から実用性への移行は順調に進んでおり、その結果は多くの人が予想するよりも微妙で、かつ浸透したものになるはずです。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。
  • | | | |

    エキスパートシステムからChatGPTへ:2026年への加速する道のり

    人工知能の軌跡は突然の爆発のように見えますが、2026年に至る道は数十年前から敷かれていました。私たちは現在、静的なソフトウェアの時代から、確率がデジタルなやり取りを左右する時代へと移行しています。この変化は、コンピュータが人間の意図を処理する方法における根本的な転換を意味します。初期のシステムは、あらゆる可能なルールを人間が手作業でコーディングすることに依存しており、そのプロセスは遅く、壊れやすいものでした。今日、私たちは膨大なデータセットからパターンを学習する大規模言語モデルを使用しており、以前は不可能だった柔軟性を実現しています。この移行は、単にチャットボットが賢くなったという話ではありません。グローバルな生産性スタックの完全な見直しなのです。今後2年間を見据えると、焦点は単純なテキスト生成から、複雑なエージェント型ワークフローへと移っています。これらのシステムは、単に質問に答えるだけでなく、異なるプラットフォーム間でマルチステップのタスクを実行するようになります。この分野で勝者となるのは、必ずしも最高の数学的アルゴリズムを持つ者ではなく、最高の流通網とユーザーからの信頼を持つ者です。この進化を理解することは、技術革新の次の波を予測しようとするすべての人にとって不可欠です。 機械論理の長い弧私たちがどこに向かっているのかを理解するには、エキスパートシステムからニューラルネットワークへの移行を見る必要があります。1980年代、AIとは「エキスパートシステム」を意味していました。これらは「もし~ならば」という文の巨大なデータベースでした。例えば、「患者が発熱と咳をしているなら、特定の感染症を検査せよ」といった具合です。論理的ではありましたが、これらのシステムは定義済みのルールから外れたニュアンスやデータを扱うことができませんでした。それらは脆かったのです。世界が変化すれば、コードを手作業で書き直さなければなりませんでした。これが、技術が自らの誇大広告に応えられなかった停滞期を招きました。その時代の論理は、私たちがより流動的なモデルへと移行している現在でも、コンピュータの信頼性に対する考え方に影響を与え続けています。現代は、2017年の研究論文で導入されたトランスフォーマーアーキテクチャによって定義されています。これにより、目標は「コンピュータにルールを教えること」から「シーケンスの次の部分を予測するように教えること」へと変わりました。椅子とは何かを教えられる代わりに、モデルは数百万枚の画像と椅子の説明を見て、椅子の統計的な本質を理解します。これがChatGPTとそのライバルの核心です。これらのモデルは、人間が知るような意味での「事実」を知っているわけではありません。前の単語の文脈に基づいて、次にくる可能性が最も高い単語を計算しているのです。この違いは極めて重要です。モデルが美しい詩を書けるのに、単純な数学の問題で失敗する理由を説明しています。一方は言語のパターンであり、もう一方は、これらのモデルを機能させるために私たちが実際に取り除いてしまった厳格な論理を必要とするからです。現在の時代は、膨大な計算能力と膨大なデータの結婚であり、人間のように感じられるが純粋な数学で動作するツールを生み出しています。グローバルな支配のインフラこの技術のグローバルな影響は、流通と直接結びついています。真空状態で開発された優れたモデルは、10億のオフィススイートに統合された少し劣ったモデルと比較して、ほとんど価値がありません。これが、MicrosoftとOpenAIの提携が業界をこれほど急速に変えた理由です。AIツールを世界がすでに使用しているソフトウェアに直接組み込むことで、ユーザーが新しい習慣を学ぶ必要性を回避しました。この流通の優位性がフィードバックループを生み出します。より多くのユーザーがより多くのデータを提供し、それがさらなる改善と製品の親しみやすさにつながります。年の中頃までには、統合されたAIへの移行は、すべての主要なソフトウェアプラットフォームでほぼ普遍的なものになるでしょう。この支配は、世界の労働市場に重大な影響を及ぼします。私たちは、デジタルタスクの「中間管理」が自動化されるシフトを目の当たりにしています。外部委託のテクニカルサポートや基本的なコーディングに大きく依存している国々では、バリューチェーンを上に移動させる圧力が高まっています。しかし、これは雇用の喪失という一方的な話ではありません。高度なスキルの民主化でもあります。Pythonの正式な訓練を受けていない人でも、今ではローカルのビジネスデータを分析するための機能的なスクリプトを生成できます。包括的な人工知能分析は、これが以前は専任のデータサイエンスチームを雇う余裕がなかった発展途上国の小規模企業にとって、競争の場を公平にしていることを示しています。これらのモデルを実行するために必要なハードウェアをめぐって各国が競争する中、地政学的なリスクも高まっています。Stanford HAIによると、ハイエンドチップの管理はエネルギー資源の管理と同じくらい重要になっています。この競争が、次の10年の経済的境界線を決定づけるでしょう。新しい知能との共生2026年のプロジェクトコーディネーターの1日を考えてみましょう。彼女の朝は、100通の個別のメールをチェックすることから始まりません。代わりに、AIエージェントがすでに3つの異なるタイムゾーンからの夜間の通信を要約しています。それはシンガポールでの出荷遅延にフラグを立て、過去の契約条件に基づいて3つの潜在的な解決策を起草しています。彼女はタイピングに時間を費やすことはありません。代わりに、システムが行った選択を確認し、承認することに時間を費やします。これは、作成者から編集者へのシフトです。この転換点は、AIは目的地となるウェブサイトではなく、バックグラウンドサービスであるべきだという認識でした。今では、特定のログインや別のタブを必要とせずに、日常業務の構造に織り込まれています。クリエイティブ業界では、その影響はさらに顕著です。マーケティングチームは、数週間ではなく数時間で高品質なビデオキャンペーンを作成できるようになりました。彼らはモデルを使用してスクリプトを生成し、別のモデルでナレーションを作成し、3番目のモデルでビジュアルをアニメーション化します。失敗のコストはほぼゼロにまで低下し、絶え間ない実験が可能になりました。しかし、これは新しい問題を生み出します。コンテンツの過剰供給です。誰もが「完璧な」素材を作成できるとき、その素材の価値は低下します。現実世界への影響は、真正性と人間が検証した情報へのシフトです。Natureの研究は、人々が人間が関与したことを示す不完全さを求め始めていることを示唆しています。「人間味」へのこの欲求は、合成コンテンツがデフォルトになるにつれて、プレミアムな市場セグメントになる可能性が高いです。これらのモデルが「思考」や「推論」をしているという一般的な誤解があります。実際には、高速な検索と合成を行っているに過ぎません。ユーザーがモデルに旅行の旅程を計画するように頼むとき、モデルは地図を見ているわけではありません。旅行の旅程が通常どのように構成されているかのパターンを思い出しているのです。物事がうまくいかないとき、この違いが重要になります。モデルが存在しないフライトを提案した場合、それは嘘をついているのではありません。単に統計的にありそうな、しかし事実としては誤った文字列を提供しているだけです。この一般認識と現実の乖離こそが、ほとんどの企業リスクが存在する場所です。人間の監視なしに法的または医療的なデータを処理するためにこれらのシステムを信頼する企業は、「ハルシネーション(幻覚)」の問題が簡単に修正できるバグではないことに気づき始めています。それは、この技術がどのように機能するかという根本的な部分なのです。 BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 合成の未来に向けた難しい問いこれらのシステムを私たちの生活に深く統合するにつれて、私たちは自問しなければなりません。この利便性の隠れたコストは何でしょうか?大規模モデルに送信されるすべてのクエリは、データセンターを冷却するためにかなりの量の電気と水を必要とします。単純な検索クエリが5年前の10倍のエネルギーを消費するようになった今、回答のわずかな改善は環境への負担に見合う価値があるのでしょうか?また、トレーニングに使用されるデータのプライバシーも考慮しなければなりません。今日私たちが使用しているモデルのほとんどは、作成者の明示的な同意なしにオープンインターネットをスクレイピングすることによって構築されました。強力なAIの公共の利益は、その実現を可能にしたアーティストや作家の個人の権利を上回るのでしょうか?もう一つの難しい問いは、ニューラルネットワークの「ブラックボックス」の性質に関わります。AIがローンや医療処置を拒否する決定を下し、開発者自身がなぜモデルがその結論に達したのかを正確に説明できない場合、私たちはそのシステムを本当に公平と呼べるでしょうか?私たちは透明性をパフォーマンスと引き換えにしています。これは、私たちの法的および司法制度において私たちが受け入れるべき取引なのでしょうか?また、権力の集中にも目を向けなければなりません。これらのモデルをトレーニングするために必要な数十億ドルを負担できる企業がほんの一握りしかない場合、自由で開かれたインターネットという概念はどうなるのでしょうか?私たちは、「真実」とは最も強力なモデルが言うことである、という未来に向かっているのかもしれません。これらは、より多くのコードで解決できる技術的な問題ではありません。それらは人間の介入を必要とする哲学的および社会的な課題です。MIT Technology Reviewが指摘するように、私たちが今行う政策決定が、今後50年間の力のバランスを決定することになります。 モダンスタックの内部パワーユーザーにとって、焦点はチャットインターフェースを超え、ローカル実行とAPIオーケストレーションの領域へと移っています。クラウドベースのモデルが最も生に近いパワーを提供しますが、ローカルストレージと実行の台頭こそが2026年の真の物語です。OllamaやLlama.cppのようなツールは、ユーザーが自分のハードウェア上で、より小さく、非常に有能なモデルを実行することを可能にします。これはプライバシーの問題を解決し、サーバーへの往復の遅延を取り除きます。市場のギーク層は現在、量子化(quantization)に夢中です。これは、知能をあまり失うことなく標準的なコンシューマーGPUに収まるようにモデルを縮小するプロセスです。ワークフローの統合は、現在、洗練されたRAG(検索拡張生成)パイプラインを通じて処理されています。すべてのデータをモデルに送信する代わりに、ドキュメントをベクトルデータベースに保存します。質問をすると、システムはデータの関連するスニペットを見つけ、それらのみをコンテキストとしてモデルに供給します。これにより、多くのシステムを悩ませている厳格なコンテキストウィンドウの制限を回避できます。APIの制限は依然として大量のアプリケーションにとってボトルネックであり、多くの開発者が「モデルルーティング」を実装するようになっています。これは、安価で高速なモデルが簡単なクエリを処理し、難しい質問だけが高価なハイエンドモデルに送信されるという戦略です。このアプローチは、単一のプロバイダーに依存するよりも、コストを削減し、遅延をより効果的に管理します。また、インターネット全体ではなく、特定の高品質なデータセットでトレーニングされた「スモール言語モデル」への動きも見られます。これらのモデルは、コーディングや法務分析などの専門的なタスクにおいて、より大きなモデルよりも優れたパフォーマンスを発揮することが多く、必要な計算能力はわずかです。ワークフロー内でこれらのモデルを入れ替える能力は、現代のソフトウェアアーキテクチャの標準要件になりつつあります。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 次の地平線2026年への道は、一直線の進歩ではなく、一連のトレードオフです。私たちは、透明性と予測可能性を犠牲にして、信じられないほどのスピードと柔軟性を手に入れました。ハイテク大手の流通の優位性により、AIは日常生活のいたるところに存在するようになりましたが、これらのモデルがどのように機能するかという根本的な現実は、一般の人々には依然として誤解されています。2026年を見据えると、焦点はモデルを大きくすることから、より効率的で自律的なものにすることへと移るでしょう。最も成功する個人や企業は、AIを全知全能の神託としてではなく、強力だが間違いを犯す可能性のあるパートナーとして扱う人々です。残されたライブな問いは、古いエキスパートシステムの推論と現代のニューラルネットワークの言語的流動性を兼ね備えたシステムを構築できるかどうかです。それまでは、ループ内の人間が方程式の最も重要な部分であり続けます。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。
  • | | | |

    プライバシー、スピード、制御を両立する最高のオープンモデル

    クラウド専用のAI時代は終わりを迎えようとしています。OpenAIやGoogleが大規模言語モデルの第一波を席巻しましたが、現在はローカル実行への大きなシフトが起きており、企業や個人のソフトウェアとの関わり方が劇的に変化しています。ユーザーは、プライベートな思考や企業の機密情報を遠くのサーバーに送信したくはありません。自分のハードウェアで強力なシステムを動かす方法を求めているのです。この動きを牽引しているのがオープンモデルの台頭です。これは、基盤となるコードや重みが誰でもダウンロードして実行できるシステムのことを指します。この変化は、わずか2年前には不可能だったレベルのプライバシーと制御を提供します。仲介者を排除することで、組織はデータを自社の壁の中に留めることができます。これは単にAPI料金を節約するだけの話ではありません。この10年で最も重要なテクノロジーに対するローカル主権を確立することなのです。2026が進むにつれ、焦点は「誰が最大のモデルを持っているか」から「ラップトップやプライベートサーバーで動かせる最も便利なモデルはどれか」へと移り変わっています。 ローカルインテリジェンスへのシフトマーケティングと現実の違いを理解することが、これらのツールを使いこなす第一歩です。多くの企業が自社のモデルを「オープン」と謳っていますが、その言葉はしばしば曖昧に使われています。真のオープンソースソフトウェアとは、誰でもコードを確認し、修正し、あらゆる目的で利用できるものです。AIの世界で言えば、学習データ、学習コード、そして最終的なモデルの重みにアクセスできることを意味します。しかし、Meta LlamaやMistralのような人気モデルの多くは、実際には「オープンウェイト(重み公開)」モデルです。つまり、最終製品はダウンロードできても、それがどのように構築されたか、どのようなデータで学習されたかは正確には分かりません。Apache 2.0やMITのような寛容なライセンスは自由のゴールドスタンダードですが、多くのオープンウェイトモデルには制限付きの条項が付いています。例えば、特定の業界での使用を禁止したり、ユーザーベースが大きくなると有料ライセンスを要求したりするケースがあります。オープンさの階層を理解するために、次の3つのカテゴリーを考慮してください:真のオープンソース:Allen Institute for AIのOLMoプロジェクトのように、データソースや学習ログを含む完全なレシピを提供するモデル。オープンウェイト:ローカルで実行可能だが、レシピは秘密のまま。ほとんどの商用オープンモデルがこれに該当します。研究専用:ダウンロードは可能だが、商用製品には使用できず、学術環境に限定されるもの。開発者にとってのメリットは明らかです。許可を求めることなく、これらのモデルを自分のアプリに統合できます。企業にとっては、導入前にセキュリティの欠陥を監査できるという利点があります。一般ユーザーにとっては、インターネット接続なしでAIを使えることを意味します。これは、ユーザーとプロバイダー間の力関係における根本的な変化です。シリコンの時代におけるグローバル主権オープンモデルが世界に与える影響は、シリコンバレーのテック拠点だけにとどまりません。多くの国にとって、AIのニーズを少数の米国企業に依存することは戦略的リスクです。各国政府は、データの居住地や、自国の言語や文化を反映したシステムを構築する能力を懸念しています。オープンモデルがあれば、ラゴスの開発者やベルリンのスタートアップが、外国の巨大企業に賃料を払うことなく専門ツールを構築できます。これはグローバルな競争の場を公平にします。また、検閲や安全性に関する議論も変えます。モデルがクローズドであれば、何が言えて何が言えないかをプロバイダーが決めてしまいます。オープンモデルは、その力をユーザーの手に取り戻すのです。このシフトの主な原動力はプライバシーです。多くの管轄区域では、GDPRのような法律により、機密性の高い個人情報をサードパーティのAIプロバイダーに送信することが困難になっています。モデルをローカルで実行すれば、病院は患者の記録を処理でき、法律事務所は機密保持ルールに違反することなく証拠開示文書を分析できます。これは知的財産を守りたい出版社にとって特に重要です。彼らは、将来的に自社と競合する可能性のあるシステムにデータをフィードバックすることなく、オープンモデルを使ってアーカイブを要約したり分類したりできます。利便性と制御の間の緊張関係は現実です。クラウドモデルは使いやすくハードウェアも不要ですが、主体性を失います。オープンモデルは技術的なスキルを必要としますが、完全な独立性を提供します。テクノロジーが成熟するにつれ、これらのモデルを実行するためのツールは専門家以外でも使いやすくなっています。この傾向は、独自の秘密よりも透明性を優先する最新のAIガバナンスのトレンドにも表れています。専門的なワークフローにおける実用的な自律性現実世界では、オープンモデルの影響は、専門化された小規模なシステムへの移行に見られます。すべてをこなそうとする巨大なモデルではなく、特定のタスクに合わせて調整された小さなモデルが使われています。ソフトウェアエンジニアのサラの日常を想像してみてください。彼女は朝、コードエディタを開きます。独自のコードをクラウドベースのアシスタントに送信する代わりに、彼女はワークステーションで実行されているローカルモデルを使用します。これにより、会社の企業秘密がマシンから決して流出しないことが保証されます。その後、彼女は大量の顧客フィードバックを処理する必要があります。彼女は社内のプライベートクラウド上でモデルのインスタンスを立ち上げます。API制限がないため、電気代だけで数百万行のテキストを処理できるのです。 ジャーナリストや研究者にとっても、メリットは同様に重要です。彼らは検索クエリが追跡されることを心配せずに、リークされた文書の膨大なデータセットを掘り下げるためにこれらのツールを使用できます。最大限のセキュリティのために、エアギャップ(オフライン)のコンピューターでモデルを実行することも可能です。ここで「同意」という概念が重要になります。クラウドモデルでは、データがシステムの将来のバージョンを学習するために使用されることがよくあります。オープンモデルでは、そのサイクルが断ち切られます。入力と出力の唯一の所有者はあなたです。しかし、同意の現実は複雑です。ほとんどのオープンモデルは、元の作成者の明示的な許可なしにインターネットからスクレイピングされたデータで学習されました。ユーザーにはプライバシーがあっても、元のデータ所有者は学習段階で権利が無視されたと感じるかもしれません。これは、クリエイターがより良い保護を求める2026における主要な議論のポイントです。 このシフトは、ハードウェアに対する考え方にも影響を与えます。クラウドに依存する薄型ラップトップを購入する代わりに、強力なローカルプロセッサを搭載したマシンの市場が拡大しています。これは、最高のAIパフォーマンスを提供するために競い合うハードウェアメーカーにとっての新しい経済圏を生み出しています。クラウドの利便性は依然として多くの人にとって大きな魅力ですが、トレンドはハイブリッドアプローチに向かっています。ユーザーは、簡単なクリエイティブタスクにはクラウドモデルを使い、機密データに関わるものにはローカルモデルに切り替えるかもしれません。この柔軟性こそがオープンムーブメントの真の価値です。それは知能の独占を打ち破り、より多様なツールエコシステムを可能にします。Hugging Faceのようなプラットフォームは、あらゆるユースケースに対応する何千ものモデルをホストし、この新しい働き方の中心的なハブとなっています。 オープンムーブメントへの厳しい問いオープンモデルへの移行は有望ですが、業界がしばしば無視する困難な問題を提起しています。この自由の隠れたコストは何でしょうか?これらのモデルを実行するには、かなりの電力と高価なハードウェアが必要です。すべての企業が独自のプライベートAIクラスターを運営すれば、中央集権的で効率的なデータセンターと比較して、環境への全体的な影響はどうなるのでしょうか?また、モデルの品質についても問わなければなりません。オープンウェイトは、クローズドな環境で開発された数十億ドル規模のシステムと同等の能力があるのでしょうか?もしオープンモデルとクローズドモデルの差が広がれば、プライバシーのメリットはパフォーマンスの損失に見合うものになるのでしょうか? BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 説明責任の問題もあります。クローズドモデルが有害なコンテンツを生成した場合、責任を問うべき企業が存在します。しかし、オープンモデルが匿名ユーザーによって修正・再配布された場合、その出力に対して誰が責任を負うのでしょうか?オープンモデルの透明性はしばしば称賛されますが、実際に数百万のパラメータを監査して隠れたバイアスを見つけるスキルを持つ人がどれだけいるでしょうか?「オープン」という言葉が、規制を避けるための盾として使われていないか検討する必要があります。モデルを野に放つことで、企業は「使い方は制御できない」と主張できます。この分散化は本当に私たちをより安全にするのでしょうか、それとも倫理基準の強制を難しくするだけなのでしょうか?最後に、データの問題です。もしオープンモデルが同意なしのデータで学習された場合、それをローカルで使用することはユーザーの加担になるのでしょうか?これらは単なる技術的な問題ではありません。次の10年のAI開発を定義する、社会的かつ法的な課題なのです。Meta AIのようなグループの研究は、オープンさがより迅速な安全性の向上につながることを示唆していますが、これは依然として議論の的となっています。ローカル実装のアーキテクチャブラウザを超えて進む準備ができている人にとって、ローカルAIの技術要件は具体的です。最も重要な要素はVRAM(ビデオRAM)です。ほとんどのオープンモデルは、妥当なレイテンシレベルで実行するために最新のグラフィックカードを必要とする形式で配布されています。これらのモデルをコンシューマー向けハードウェアに収めるために、開発者は「量子化」と呼ばれるプロセスを使用します。これによりモデルの重みの精度が低下し、精度の低下を最小限に抑えつつメモリ要件を大幅に削減できます。これにより、本来40GBのVRAMを必要としていたモデルを、標準的な12GBや16GBのカードで実行できるようになります。ローカル実行のための一般的な形式とツールには以下があります:GGUF:CPUとGPUの両方で使用できるように設計された形式。MacやWindowsハードウェアでの実行に人気があります。EXL2:NVIDIA GPU向けに最適化された高性能形式。非常に高速なテキスト生成を可能にします。Ollama:バックグラウンドでモデルのダウンロードと実行を管理する簡素化されたツール。 モデルのスペックを見る際は、コンテキストウィンドウに注目してください。これはモデルが一度にどれだけの情報を記憶できるかを決定します。一部のクラウドモデルは巨大なウィンドウを提供しますが、ローカルモデルは利用可能なシステムメモリによって制限されることがよくあります。ここではAPI制限は問題になりませんが、トレードオフとしてローカルストレージが必要です。高品質なモデルは5GBから50GBの容量を占有します。開発者にとって、これらのモデルをワークフローに統合することは、多くの場合、OpenAIのAPI構造を模倣したローカルサーバーを使用することを意味します。これにより、コードを1行変更するだけでクラウドベースのモデルをローカルモデルに切り替えることができます。この互換性こそが、オープンエコシステムが急速に成長した大きな理由です。単一のベンダーエコシステムに縛られることなく、迅速なテストと展開が可能になるのです。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 デジタル独立への道オープンモデルとクローズドモデルの選択は、利便性と自律性の選択です。クローズドモデルは、おそらく常にわずかに強力で使いやすいでしょう。しかし、オープンモデルは真のプライバシーと長期的な制御への唯一の道を提供します。データを大切にする企業や個人にとって、ローカルハードウェアと専門知識への投資は必要不可欠になりつつあります。このテクノロジーは、もはや愛好家のための好奇心の対象ではありません。ビッグテックの支配に挑戦する、堅牢な代替手段なのです。今後を見据えると、AIをローカルで実行できる能力は、デジタル体験を定義する機能となるでしょう。それは、このテクノロジーの力が少数の手に集中するのではなく、多くの人々に分散されることを保証します。このシフトは、ユーザーがようやく自分自身の知能の主導権を取り戻す、より回復力がありプライベートなインターネットの始まりを告げるものです。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。