ai, artificial intelligence, artificial, intelligence, network, programming, web, brain, computer science, technology, printed circuit board, information, data, data exchange, digital, communication, neuronal, social media, artificial intelligence, artificial intelligence, artificial intelligence, artificial intelligence, artificial intelligence, programming, brain, brain, brain

類似投稿

  • | | | |

    AIをローカルで動かすべき最高の理由 2027

    クラウド全盛の時代ですが、皆さんのデスクにあるハードウェアが静かながらも強力な挑戦を始めています。ここ数年、大規模言語モデルを使うということは、巨大企業が所有するサーバーファームにデータを送信することを意味していました。テキストやコードを生成するために、プライバシーやファイルを差し出していたのです。しかし、その取引はもう必須ではありません。コンシューマー向けチップがインターネット接続なしで数十億のパラメータを扱えるほど強力になった今、ローカル実行へのシフトが勢いを増しています。これは単なるホビーやプライバシー愛好家のトレンドではありません。ソフトウェアとの付き合い方における根本的な変化です。モデルをローカルで動かせば、ウェイトも入力も出力も、すべて自分のものになります。月額のサブスクリプション料金も、一夜にして変わる利用規約もありません。オープンウェイトの進化の速さにより、標準的なノートPCで、かつてはデータセンターが必要だったタスクをこなせるようになりました。この自立への動きが、パーソナルコンピューティングの境界線を再定義しています。 プライベートAIの仕組みAIモデルを自分のハードウェアで動かすということは、リモートサーバーで行われていた数学的な重労働を、ローカルのGPUや統合ニューラルエンジンに移行させることを意味します。クラウドモデルでは、プロンプトがインターネットを経由してプロバイダーに送られ、処理されて返ってきます。一方、ローカル環境ではモデル全体が自分のハードドライブに収まっています。クエリを入力すると、システムメモリがモデルのウェイトを読み込み、プロセッサが回答を計算します。このプロセスはビデオメモリ(VRAM)に大きく依存します。モデルを構成する数十億の数値に瞬時にアクセスする必要があるからです。Ollama、LM Studio、GPT4Allといったソフトウェアがインターフェースとして機能し、MetaのLlama 3やフランスのチームによるMistralといった様々なモデルをロードできます。これらのツールは、すべてのデータをマシン内に留めたまま、AIとやり取りするためのクリーンな環境を提供します。ドキュメントの要約やスクリプトの作成に光ファイバー接続は不要です。モデルは、ワープロや写真編集ソフトと同じように、PC上の単なるアプリケーションになります。このセットアップにより、データの往復による遅延が解消され、作業内容を外部の目に触れさせずに済みます。元のファイルを圧縮した「量子化モデル」を使うことで、ハイエンドな研究用ではないハードウェアでも驚くほど大規模なシステムを動かせます。焦点は巨大なスケールから効率的な実行へと移りました。これにより、クラウドプロバイダーには真似できないレベルのカスタマイズが可能になり、タスクに合わせて数秒でモデルを切り替えることもできます。 グローバルなデータ主権とコンプライアンスローカルAIが世界に与える影響は、データ主権と国際的なプライバシー法の厳しい要件に集約されます。欧州連合(EU)のような地域では、GDPRが、機密性の高い顧客データをクラウドベースのAIで扱おうとする企業にとって大きなハードルとなっています。医療記録や財務履歴をサードパーティのサーバーに送ることは、多くの企業が受け入れがたい法的リスクを生みます。ローカルAIは、データを企業や国の物理的な境界内に留めることで、その解決策を提供します。これは、セキュリティ上の理由でインターネット接続が厳しく制限された「エアギャップ」環境で運用される政府機関や防衛関連企業にとって特に重要です。法的枠組みを超えて、文化的・言語的な多様性の問題もあります。クラウドモデルは、それらを構築したシリコンバレー企業の価値観を反映した特定のバイアスやフィルターで微調整されていることがよくあります。ローカル実行なら、世界中のコミュニティがベースモデルをダウンロードし、独自のデータセットで微調整することで、中央当局の干渉を受けずに現地の言語や文化的なニュアンスを保持できます。現在、特定の管轄区域や業界に特化したモデルが増加しています。この分散型アプローチにより、テクノロジーの恩恵が単一の地理的または企業的な門番によって独占されることはありません。また、インターネットインフラが不安定な国々のユーザーにとってもセーフティネットとなります。ウェブのバックボーンがダウンしても、遠隔地の研究者はローカルモデルを使ってデータを分析したり翻訳したりできます。基盤技術の民主化は、これらのツールを構築・利用する力が、従来のテックハブをはるかに超えて広がっていることを意味します。 オフラインワークフローの活用厳格な知的財産ルールを持つ企業で働くソフトウェアエンジニア、エリアスの日常を考えてみましょう。彼は仕事でよく移動し、Wi-Fiがなかったり不安定だったりする飛行機や電車の中で何時間も過ごします。以前のワークフローでは、オフィスを出た瞬間に生産性が低下していました。会社の機密コードベースを外部サーバーにアップロードすることが禁じられていたため、クラウドベースのコーディングアシスタントを使えなかったからです。今、エリアスはローカルで動作するコーディングモデルを搭載したハイエンドなノートPCを持ち歩いています。高度3万フィートの座席で、複雑な関数をハイライトし、モデルにパフォーマンス向上のためのリファクタリングを依頼できます。モデルはローカルでコードを分析し、数秒で改善案を提示します。サーバーの応答を待つ必要も、データ漏洩のリスクもありません。彼のワークフローは場所を問わず一貫しています。これは、インターネット接続が監視・制限されている紛争地域で活動するジャーナリストにも同じメリットをもたらします。彼らはローカルモデルを使って、インタビューの書き起こしやメモの整理を、機密情報が敵対的なアクターに傍受される恐れなしに行えます。中小企業のオーナーにとっても、収益面でのインパクトは絶大です。従業員全員に月額20ドルのサブスクリプションを支払う代わりに、高性能なワークステーションに投資すればいいのです。これらのマシンでメールのドラフト作成、マーケティングコピーの生成、売上スプレッドシートの分析をこなせます。コストは一度限りのハードウェア購入であり、毎年増え続ける運用費ではありません。ローカルモデルには「システムダウン」のページも、締め切り直前に作業を止めるレート制限もありません。電源さえあればいつでも使えます。この信頼性が、AIを気まぐれなサービスから頼れるツールへと変貌させるのです。 BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 中間業者を排除することで、ユーザーは自分の時間と創造的なプロセスに対する主導権を取り戻します。私たちが常時接続されながらも常に監視されているという現代のウェブの矛盾は、使う知能が自分自身の思考と同じくらいプライベートなものになれば、消え去り始めるのです。 ローカル利用の現実的な限界ローカルAIへの移行は、すべてのユーザーにとって常に正しい選択でしょうか?ハードウェアや電気代の隠れたコストが、クラウドの利便性を上回るのではないかという問いは避けられません。自分のマシンで大規模モデルを動かすということは、自分がシステム管理者になるということです。モデルが支離滅裂な回答をしたり、最新のドライバーアップデートでインストールが壊れたりしても、電話できるサポートチームはいません。ハードウェアの冷却にも責任を持つ必要があり、長時間のセッションでは大きな問題になり得ます。ハイエンドなGPUは数百ワットの電力を消費し、小さなオフィスを非常に暑い部屋に変え、光熱費を押し上げます。モデルの品質の問題もあります。オープンソースモデルは急速に改善していますが、数十億ドル規模のクラウドシステムの最先端には及ばないことがよくあります。ノートPCで動く70億パラメータのモデルが、スーパーコンピュータで動く1兆パラメータのモデルと真に競えるのでしょうか?単純なタスクならイエスですが、複雑な推論や膨大なデータの合成では、ローカル版は力不足かもしれません。また、ローカル利用のために何百万ものハイエンドチップを製造する環境負荷と、中央集中型データセンターの効率性を比較する必要もあります。プライバシーは強力な論拠ですが、自分の「ローカル」ソフトウェアが裏でこっそり外部通信していないことを検証できる技術スキルを持つユーザーはどれほどいるでしょうか?ハードウェア自体が参入障壁でもあります。最高のAI体験に3000ドルのコンピュータが必要なら、新たなデジタルデバイドを生み出しているのではないでしょうか?これらの疑問は、ローカルAIがクラウドの完全な代替ではなく、専門的な選択肢であることを示唆しています。完全なコントロールを求める欲求と、技術的な複雑さや物理的な制約という現実とのバランスを取る必要があるのです。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 技術アーキテクチャとVRAMのターゲットパワーユーザーにとって、ローカルAIへの移行はハードウェアの最適化とメモリ管理のゲームです。最も重要な指標はCPUの速度ではなく、グラフィックスカードのVRAM容量です。最近のモデルの多くはGGUFやEXL2という形式で配布されており、効率的にメモリにロードできます。70億パラメータのモデルを快適に動かすには、一般的に少なくとも8GBのVRAMが必要です。130億や3000億パラメータのモデルを目指すなら、16GBから24GBのメモリが視野に入ります。これが、コミュニティでNVIDIA RTX 3090や4090が人気な理由です。Apple側では、Mシリーズチップのユニファイドメモリアーキテクチャにより、RAMの大部分をビデオメモリとして使用できるため、128GBのRAMを積んだMac Studioはローカル推論のパワーハウスとなります。*量子化*は、モデルのウェイトの精度を16ビットから4ビットや8ビットに下げることでこれを可能にする技術プロセスです。これにより、出力の知能をわずかに犠牲にするだけで、ファイルサイズとメモリ要件を大幅に削減できます。ローカルストレージも重要で、高品質なモデル1つで5GBから50GBの容量を占有します。ほとんどのユーザーは、コマンドラインツールや、Hugging Faceのようなリポジトリに接続する専用ブラウザを使ってライブラリを管理しています。これらのモデルをプロのワークフローに統合するには、ローカルAPIサーバーのセットアップが必要になることがよくあります。OllamaのようなツールはOpenAI APIを模倣したエンドポイントを提供し、VS CodeやObsidianの既存のソフトウェアプラグインでローカルモデルを使えるようにします。これにより、ソフトウェア側はクラウドと通信していると思い込みながら、データは決してローカルネットワークの外に出ないというシームレスな移行が可能になります。高VRAMのNVIDIA RTX GPUはPCユーザーの標準です。Apple Siliconは、大規模モデルに対して最も効率的なメモリ共有を提供します。 戦略的な選択AIワークフローをローカルに移行するという決断は、データをどこに置くかという戦略的な選択です。「サービスとしてのソフトウェア(SaaS)」モデルから離れ、個人の所有権という時代への回帰です。クラウドは最も要求の厳しいタスクにおいて常に最高のパフォーマンスを提供し続けますが、日常的な用途ではその差は縮まっています。開発者、ライター、そしてプライバシーを重視するプロフェッショナルにとって、オフラインアクセスとデータセキュリティのメリットは無視できないほど大きくなっています。ハードウェアの準備は整い、モデルは利用可能になり、ソフトウェアも毎月使いやすくなっています。あなたはもう、サブスクリプションやサーバーのステータスページに縛られることはありません。必要な知能は、今やあなたのローカルツールキットの不可欠な一部となったのです。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。
  • | | | |

    次世代AIの波を先導するラボの最前線

    現在の人工知能(AI)は、もはや抽象的な研究論文や遠い未来の約束で語られるものではありません。私たちは、膨大なコンピューティングパワーを信頼性の高い実用的なツールへと変換する、産業的アウトプットの時代に突入しました。この変革をリードするラボは一様ではなく、論理の拡張を優先する場所もあれば、スプレッドシートやクリエイティブスイートへの統合に注力する場所もあります。このシフトにより、議論の焦点は「いつか起こりうること」から「今、サーバー上で実際に機能していること」へと移っています。私たちは、今後10年の経済的勝者を決定づける戦略の分岐点に立っています。開発スピードは凄まじく、企業は追いつくのに必死です。もはや最高のモデルを持っているだけでは不十分です。システムをクラッシュさせたり、致命的なハルシネーション(誤情報)を引き起こしたりすることなく、何百万人ものユーザーが同時に利用できるほど安価で高速なモデルを作れるかどうかが、業界の新たな基準となっています。 現代の機械知能を支える3つの柱現在の軌跡を理解するには、これらのシステムを構築する組織を3つの主要タイプに分類する必要があります。第一は、OpenAIやAnthropicのような「フロンティア・ラボ」です。彼らはニューラルネットワークが処理できる限界を押し広げることに集中しています。目標は汎用的な能力であり、コーディングからクリエイティブな執筆まで、あらゆる領域で推論できるシステムの構築を目指しています。これらのラボは巨額の予算を投じ、世界中のハイエンドハードウェアの大半を消費しています。彼らは動き全体のエンジンルームであり、誰もが最終的にその上に構築するベースモデルを提供しています。第二は、Stanford HAIやMIT CSAILのような「アカデミック・ラボ」です。彼らの役割は異なります。彼らは懐疑論者であり、理論家です。フロンティア・ラボがモデルの巨大化に注力する一方で、アカデミック・ラボは「なぜそのモデルが機能するのか」を問いかけます。彼らは社会的影響、内在するバイアス、長期的な安全性の意味を調査します。彼らが提供する査読済みのデータが、商業セクターの足元を固めています。彼らがいなければ、業界は公的な監視や基礎メカニズムの理解がない、プロプライエタリな秘密のブラックボックスになってしまうでしょう。最後は、Microsoft、Adobe、Googleなどの企業内にある「プロダクト・ラボ」です。これらのチームは、フロンティアから得た生のパワーを、実際に人が使えるものへと変えます。彼らはユーザーインターフェース、レイテンシ、データプライバシーという厄介な現実に直面しています。プロダクト・ラボにとって、3秒で1000ページの法務文書を正確に要約できないモデルが詩を書けるかどうかは重要ではありません。彼らは研究所とリビングルームの架け橋であり、以下の優先事項に注力しています。クエリあたりのコストを削減し、マスマーケットで持続可能な技術にすること。出力が企業のブランド安全基準に準拠するようガードレールを構築すること。メールやデザインツールなど、既存のソフトウェアワークフローに知能を統合すること。 ラボのアウトプットが持つ世界的な賭けこれらのラボで行われている作業は、単なる企業の利益にとどまりません。国家安全保障や世界経済の地位における核心的な要素となっています。これらのラボを抱える国々は、計算効率とデータ主権において大きな優位性を得ます。サンフランシスコやロンドンのラボが推論のブレイクスルーを起こせば、それは東京やベルリンのビジネスのあり方に影響を与えます。私たちは、石油産業の黎明期に匹敵する権力の集中を目の当たりにしています。高品質な知能を大規模に生成する能力は、新しいコモディティです。これにより、労働の価値そのものが問われる競争が始まっています。政府は今、これらのラボを戦略的資産と見なしています。アカデミック研究のオープンな性質と、フロンティア・ラボの閉鎖的でプロプライエタリな性質の間で緊張が高まっています。最高のモデルがペイウォールの背後に隠されれば、技術的に豊かな国と貧しい国の格差は広がるでしょう。そのため、多くのラボは現在、データソースやエネルギー消費の説明を強く求められています。これらの巨大システムをトレーニングするための環境コストは、まだどのラボも完全に解決できていない世界的な懸念です。データセンターを稼働させるために必要なエネルギーは、バージニアからシンガポールに至るまで、電力網の再考を迫っています。 日常的な実用性への架け橋モデルが司法試験に合格したという研究論文と、弁護士がクライアントの案件を任せられるプロダクトの間には、大きな隔たりがあります。ニュースで目にするものの多くは研究のシグナルですが、市場のノイズが実際の進歩を隠してしまうことがよくあります。ラボでのブレイクスルーが消費者向けデバイスに届くまでには2年かかることもあります。この遅延は最適化の必要性によるものです。1万個のGPUを必要とするモデルは、中小企業には無用です。来年の本当の仕事は、これらのモデルをノートPCで動かせるほど小型化しつつ、その知能を維持することです。近い将来のソフトウェア開発者の日常を想像してみてください。彼らは真っ白な画面から始めることはありません。代わりに、特定のコードベースに合わせてファインチューニングされたローカルモデルに機能を説明します。モデルがボイラープレートを生成し、セキュリティの脆弱性をチェックし、最適化を提案します。開発者は手作業の労働者ではなく、アーキテクト兼エディターとして振る舞います。このシフトは、プロダクト・ラボが、データをパブリックインターネットに漏らすことなく、特定の企業のデータコンテキストをモデルに理解させる方法を見出したからこそ可能になったのです。 BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 これが汎用AIと実用的なAIの違いです。 クリエイターにとって、その影響はさらに直接的です。ビデオエディターは、Google DeepMindのようなラボのツールを使って、ロトスコープやカラーグレーディングといった最も退屈な作業を自動化できるようになりました。これはエディターに取って代わるものではなく、制作コストを変えるものです。1週間かかっていた作業が今では1時間で終わります。これにより、高品質なストーリーテリングがより多くの人に利用可能になりますが、同時に市場がコンテンツで溢れかえることにもなります。ラボにとって現在の課題は、人間が作ったものと機械が生成したものを見分けるためのツールを作ることです。この信頼性こそが、業界にとって次の大きなハードルです。 アーキテクトへの厳しい問い私たちがこれらのラボに依存するにつれ、彼らの主張に対してソクラテス的な懐疑心を持つ必要があります。この利便性の裏に隠されたコストは何でしょうか?もし私たちが推論をモデルに外部委託してしまったら、私たちは自分で批判的に考える能力を失ってしまうのでしょうか?データ所有権の問題もあります。これらのモデルのほとんどは、クリエイターの明示的な同意なしにインターネット上の集合的なアウトプットを学習しました。ラボが数百万人のアーティストや作家の作品から、対価を払わずに利益を得ることは倫理的でしょうか?これらは単なる法的な問いではなく、クリエイティブ経済の未来にとって根本的な問題です。 プライバシーは依然として最大の懸念事項です。モデルと対話するとき、多くの場合、個人情報や独自の機密情報を入力しています。そのデータがモデルの次バージョンのトレーニングに使われていないと、どうして確信できるでしょうか?一部のラボは「データ保持ゼロ」ポリシーを掲げていますが、平均的なユーザーがその主張を検証することはほぼ不可能です。また、これらの企業の長期的な安定性についても問う必要があります。もしフロンティア・ラボが倒産したり利用規約を変更したりした場合、そのラボのAPIにインフラ全体を構築していた企業はどうなるのでしょうか?私たちが作り出している依存関係は深刻であり、潜在的に危険です。 デプロイメントの技術的制約パワーユーザーや開発者にとって、焦点は業界の「ギークセクション」、つまり配管(インフラ)へと移っています。私たちはチャットインターフェースの目新しさを超え、深いワークフロー統合の世界へと進んでいます。これにはAPI制限、トークンコスト、レイテンシの管理が含まれます。応答に5秒かかるモデルは、音声アシスタントやゲームエンジンのようなリアルタイムアプリケーションには遅すぎます。ラボは現在「Time to First Token(最初のトークンまでの時間)」を競い合っており、ミリ秒単位で応答時間を削り、対話を自然に感じさせようとしています。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 ローカルストレージとオンデバイス推論が新たな戦場となっています。すべてのリクエストをクラウドの巨大サーバーに送るのではなく、企業はより小さく専門化されたモデルをユーザーのハードウェア上で直接動かしたいと考えています。これによりプライバシーの問題が解決され、プロバイダーのコストも削減されます。しかし、これにはチップ設計とメモリ管理における飛躍的な進歩が必要です。モデルをどのように圧縮し、デプロイするかについて、新しい技術基準が生まれつつあります。現在の技術環境は、以下の3つの要因によって定義されています。コンテキストウィンドウサイズ:モデルが単一セッション中に「記憶」できる情報の量。量子化:精度を大きく損なうことなく、より強力でないハードウェアで動かせるようにモデルを縮小するプロセス。検索拡張生成(RAG):トレーニングデータだけに頼るのではなく、プライベートデータベース内の事実を参照できるようにする手法。最新のAI業界レポートによると、RAGへの移行はエンタープライズユーザーにとって最も重要なトレンドです。これにより、企業はフロンティア・ラボの汎用モデルを使用しつつ、自社の特定の事実に根ざした回答を得ることができます。ハルシネーションのリスクが軽減され、技術的なタスクにおいて出力がはるかに有用になります。また、メール送信やフライト予約などのタスクを実行する権限をモデルに与える「エージェント型」ワークフローも台頭しています。これにはまだ完全には到達していないレベルの信頼性が必要ですが、次の2027に向けた明確な目標となっています。 今後12ヶ月の進歩を評価する今後2027の有意義な進歩は、より大きなパラメータや印象的なベンチマークで測定されることはありません。博士号を持たない人々が、実際にどれだけこの技術を使って現実の問題を解決できるかによって測定されます。出力の一貫性の向上と「ハルシネーション率」の低下に注目すべきです。もしあるラボが、医療や法律といった特定の領域でモデルの精度が99パーセントであることを証明できれば、それは少し詩がうまく書けるモデルよりも大きな勝利です。業界は「ワオ!」という驚きのフェーズから、「仕事」のフェーズへと移行しています。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 残された問いは、能力のプラトー(停滞)が訪れるかどうかです。一部の専門家は、これらのモデルをトレーニングするための高品質なデータが枯渇しつつあると主張しています。もしそれが事実なら、次の進歩の波は、単にデータと計算量を増やすことではなく、アーキテクチャの変更から生まれるはずです。ラボがこの「データの壁」にどう対応するかが、AIが現在のペースで進化し続けるのか、それとも洗練と最適化の期間に入るのかを決定づけます。その答えは、世界経済のあらゆるセクターに影響を与えることになるでしょう。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。

  • | | | |

    2026年を決定づけるAIの10の潮流

    生成AIツールのハネムーン期間は終わりを迎えようとしています。2026年までに、焦点はチャットインターフェースの目新しさから、それを支える基盤インフラへと移るでしょう。私たちは、ソフトウェアが何を語るかではなく、それがどのように駆動され、誰がモデルの重みを所有し、データがどこに保管されているかが最大の関心事となる時代に突入しています。業界は、情報が世界中でどのように処理・配信されるかという構造的なシフトに向かっています。もはや実験的なボットの話ではありません。機械知能がインターネットの根幹や物理的な電力網に統合される段階にあるのです。投資家やユーザーは、初期の興奮を通り越し、運用コストの増大や現在のハードウェアの限界に目を向け始めています。今後数ヶ月を支配するストーリーラインは、こうした根本的な制約に対処するものとなるでしょう。私たちは、中央集権的なクラウドの支配から、より断片化され専門化された環境へと移行しています。勝者となるのは、膨大なエネルギー需要と、トレーニングデータを巡る複雑化する法規制環境を管理できる企業です。 機械知能における構造的シフト最初の大きな潮流は、モデルパワーの集中です。現在、少数の企業が最先端のフロンティアモデルを支配しています。これはイノベーションのボトルネックを生んでおり、小規模なプレイヤーはこれら独自のシステムの上に構築せざるを得ません。しかし、組織が独自のハードウェアで高性能なシステムを実行できる「オープンウェイトモデル」への後押しが見られます。クローズドとオープンのシステム間の緊張関係は、企業が高いサブスクリプション料金を支払うか、自前のインフラに投資するかを決断する段階で限界点に達するでしょう。同時に、ハードウェア市場も多様化しています。長年チップ市場を独占してきた企業がある一方で、競合他社や主要クラウドプロバイダーによる自社シリコンプロジェクトが代替案を提供し始めています。このサプライチェーンの変化は、推論コストを削減し、一般的なビジネスにおいて大規模なデプロイをサステナブルにするために不可欠です。もう一つの重要な進展は、検索の破壊です。数十年間、検索バーはインターネットへの入り口でした。今や、直接回答エンジンが従来のリンクのリストに取って代わろうとしています。これはウェブの経済学を変えるものです。ユーザーがAIから完全な回答を得られれば、ソースウェブサイトをクリックする理由がなくなります。これは、トラフィックを収益源とするパブリッシャーやコンテンツクリエイターにとっての危機です。また、ローカルでのAI実行の台頭も見られます。すべてのクエリをリモートサーバーに送信する代わりに、ノートPCやスマホに搭載された新しいプロセッサが、プライベートで高速、かつオフラインでの処理を可能にします。このエッジへの動きは、低レイテンシーへのニーズと、データプライバシーへの高まる需要の両方に突き動かされています。組織は、機密性の高い企業データをサードパーティのクラウドに送ることが重大なリスクであり、ローカルのハードウェアソリューションで軽減すべきだと認識し始めています。 自動化システムが世界に与える影響これらの技術の影響は、テック業界を遥かに超えています。政府は現在、AI能力を国家安全保障の問題として扱っています。これにより、各国が国内でのチップ生産を確保するために数十億ドルを投資する「シリコン主権」の競争が起きています。ライバルが最先端のハードウェアにアクセスできないようにするための厳格な輸出管理や貿易ブロックも見られます。この地政学的な緊張は、規制の場にも反映されています。欧州連合や米国の各機関は、モデルのトレーニングやデプロイを管理するためのルールを起草中です。これらの規制は、透明性、バイアス、そして金融やヘルスケアといった重要分野での悪用の可能性に焦点を当てています。目標は、成長を許容しつつ、自動意思決定による最も危険な結果を防ぐフレームワークを作ることです。エネルギー圧力は、業界の静かなる危機です。データセンターによる電力需要は、かつてない速さで増加すると予測されています。これにより、テック企業は自らエネルギー供給者となり、サーバーを稼働させるために原子力発電や巨大なソーラーファームに投資せざるを得なくなっています。地域によっては、電力網が需要に追いつかず、データセンター建設の遅延を招いています。これは、テック企業がどこに拠点を置くかという地理的なシフトを生み出し、安価で豊富な電力がある地域が選ばれるようになっています。さらに、軍事コンテキストでの自動化システムの利用も加速しています。自律型ドローンから戦略分析ツールまで、機械知能の防衛システムへの統合は、紛争の性質を変えつつあります。これは、致死的な決定における人間の監督の役割や、自動化された戦争シナリオにおける急速なエスカレーションの可能性について、緊急の倫理的問いを投げかけています。 現実世界への統合と日常生活2026年の典型的な一日において、専門家は朝、スマホ上のローカルモデルが生成した夜間の通信要約を確認することから始めるかもしれません。これはデータがデバイスの外に出ることなく行われるため、個人のスケジュールやクライアント名が安全に保たれます。会議中、専門化されたエージェントが会話を聞き取り、リアルタイムで社内データベースと議論を照合するかもしれません。このエージェントは単に書き起こすだけではありません。プロジェクトのタイムラインにおける矛盾を特定し、過去の成功したワークフローに基づいて解決策を提案します。これが、ソフトウェアが受動的なアシスタントから作業プロセスの能動的な参加者へと変わる「エージェント的シフト」の現実です。 BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 焦点は、一般的な会話ではなく、狭い範囲での高い信頼性が求められるタスクに置かれています。この移行により、管理業務に費やす時間は削減されますが、従業員にはこれらのシステムの出力を管理するプレッシャーが増大します。メディアや情報への影響も同様に深刻です。ディープフェイクは、単純な顔の入れ替えを超え、現実と見分けがつかないほどの高精細な動画や音声へと進化しました。これがデジタルコンテンツに対する信頼の危機を招いています。これに対抗するため、信頼できるメディアには暗号署名を採用する動きが見られます。スマホで撮影されたすべての写真や動画に、その起源を証明するデジタル透かしが間もなく付与されるかもしれません。この真正性を巡る戦いは、ジャーナリズム、政治、エンターテインメントに関わるすべての人にとって主要なストーリーラインです。消費者はオンラインで見聞きするものに対してより懐疑的になっており、信頼できるブランドや検証済みのソースの価値が再評価されています。情報の検証コストは上昇しており、合成メディアの時代に確実性を提供できる者が大きな力を持つことになるでしょう。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 労働市場への影響も考慮しなければなりません。一部の仕事は置き換えられていますが、他の仕事は変革されています。最も顕著な動きは中間管理職層で見られ、AIがスケジューリング、レポーティング、基本的なパフォーマンス追跡を処理できるようになっています。これは、人間のリーダーシップがどのようなものであるべきかの再評価を迫るものです。価値は、感情的知性、複雑な問題解決、倫理的判断へとシフトしています。労働者はデジタルエージェントの艦隊を監督することを求められており、新しい技術的・管理的スキルセットが必要となっています。この変化は教育システムが適応するよりも速く進んでおり、企業が社内トレーニングプログラムで埋めようとしているタレントギャップを生み出しています。これらのツールを効果的に使える人と使えない人の間の分断は拡大しており、政府がようやく対処し始めたばかりの新しい形の経済的不平等へとつながっています。 ソクラテス的な懐疑論と隠れたコスト私たちは、この急速な導入の真のコストが何であるかを問わなければなりません。もし私たちが認知インフラを3〜4社の主要企業に依存しているなら、彼らの利益が公共の利益と乖離したとき、何が起こるのでしょうか?知能の集中は、ほとんど議論されていないリスクです。私たちはローカルでの制御をクラウドベースの利便性と引き換えにしていますが、その利便性の代償は、プライバシーの完全な喪失と、いつでも変更可能なサブスクリプションモデルへの依存です。データそのものについての問題もあります。ほとんどのモデルは、人類の文化の集合的な成果物でトレーニングされています。企業がその価値を捕捉し、元のクリエイターに報酬を支払うことなく私たちに売り戻すことは倫理的でしょうか?著作権を巡る現在の法廷闘争は、情報の所有権に関するより大きな議論の始まりに過ぎません。私たちは、これらのシステムの短期的な能力を過大評価し、長期的な構造的影響を過小評価する傾向があります。人々はどんな問題でも解決できる汎用知能を期待していますが、私たちが得ているのは、既存のソフトウェアに統合された、非常に効率的で狭い範囲のツールです。危険なのは暴走する機械ではなく、クレジットスコア、求人応募、医療処置について決定を下す、理解の及ばないアルゴリズムです。私たちは、機械の論理がそれを使う人間にとって不透明な世界を構築しています。なぜ特定の結論に至ったのかを説明できないシステムに対し、どうやって責任を問えばよいのでしょうか?これらは単なる技術的な問題ではありません。社会がどのように機能すべきかという根本的な問いです。私たちは、効率性の向上が、透明性と人間の主体性の喪失に見合う価値があるかどうかを決定しなければなりません。 パワーユーザー向けセクションこれらのシステムを構築・管理する人々にとって、焦点はワークフロー統合とローカル最適化に移っています。巨大なAPIを呼び出すだけの時代は、洗練されたオーケストレーション層に取って代わられつつあります。パワーユーザーは現在、以下の技術的制約に注目しています:APIのレート制限と、ロングコンテキストモデルのためのトークンウィンドウのコスト。精度を大幅に損なうことなく、コンシューマーグレードのハードウェアで大規模モデルを実行するための量子化の利用。モデルが最新の社内データにアクセスできるようにするためのRAG(検索拡張生成)の実装。高速かつプライベートな情報検索のためのローカルベクトルデータベースの管理。ワークフロー自動化は、もはや単純なトリガーではありません。複数のモデルを連鎖させ、小さく高速なモデルが初期ルーティングを処理し、より大きく有能なモデルが複雑な推論を処理するような構成を含みます。この階層型アプローチは、コストとレイテンシーを管理するために不可欠です。また、すべての新しいコンピューティングデバイスにおいて、NPU(ニューラルプロセッシングユニット)のような専門ハードウェアが標準化される動きも見られます。これにより、OSのバックグラウンドで実行される持続的で低電力なAI機能が可能になります。開発者にとっての課題は、単にコードを書くことではなく、これらのシステムを微調整するために使用されるデータのライフサイクルを管理することです。これらの基礎的なメカニズムを理解している20パーセントのユーザーが、次世代のソフトウェアアーキテクチャを決定づけることになるでしょう。NVMeストレージの速度が、大規模モデルの重みをメモリにロードするためのボトルネックになりつつあります。多くの推論タスクにおいて、メモリ帯域幅は純粋な計算能力よりも重要です。特定のタスクにおいて、古い大規模モデルと同等の性能を発揮する小規模言語モデル(SLM)の台頭。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 結論今後2年間は、実用主義への移行によって定義されるでしょう。業界は「素早く動き、破壊せよ」というメンタリティから、信頼性が高く、スケーラブルで倫理的なシステムを構築するための、より規律あるアプローチへと移行しています。ローカルハードウェア、専門化されたモデル、厳格な法規制遵守が標準となる新しいスタックの出現を私たちは目にしています。重要なストーリーラインは、最新のチャットボットのデモではなく、これらのツールを私たちの世界の物理的・法的構造に統合するという地道な作業についてです。成功はモデルの複雑さではなく、エンドユーザーに提供する有用性と安全性によって測定されるでしょう。誇大広告から実用性への移行は順調に進んでおり、その結果は多くの人が予想するよりも微妙で、かつ浸透したものになるはずです。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。

  • | | | |

    AIが逃れられない、最も大きな倫理的問い 2027

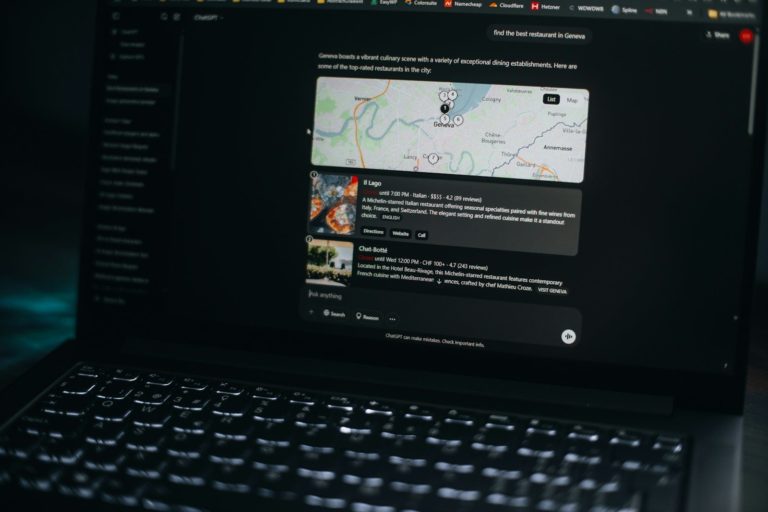
    シリコンバレーは、AIが人類の最も困難な問題を解決すると約束しました。しかし実際には、コードで解決できる範囲を超えた新たな摩擦が生じています。私たちは「驚きの時代」を過ぎ、厳しい「説明責任」が求められる時期に突入しました。核心的な問題は、未来の機械の反乱ではなく、これらのシステムが現在どのように構築され、運用されているかという現実です。すべての大規模言語モデルは、人間の労働とスクレイピングされたデータの上に成り立っています。これは、ツールを構築する企業と、その労働力を支える人々との間の根本的な対立を生んでいます。欧州や米国の規制当局は、システムが人生を台無しにするようなミスを犯した場合、誰が責任を負うのかを問い始めています。しかし、既存の法制度はこのレベルの自律性を持つソフトウェアを想定していなかったため、答えは曖昧なままです。今、私たちは「技術で何ができるか」から「公共の場で何を許容すべきか」へと議論の焦点を移しています。 自動化された意思決定の摩擦現代のAIの本質は、予測エンジンです。AIは真実や倫理を理解しているわけではありません。膨大なデータセットに基づいて、次の単語やピクセルの確率を計算しているに過ぎません。この本質的な理解の欠如が、機械の出力と人間社会の正義との間にギャップを生んでいます。銀行がアルゴリズムを使って融資の可否を判断する際、人種や郵便番号と相関するパターンを特定してしまうことがあります。これは機械が意識を持っているからではなく、学習した過去のデータにそうした偏見が含まれているからです。企業はしばしばこれらのプロセスを企業秘密の裏側に隠し、審査に落ちた人がその理由を知ることを不可能にしています。この透明性の欠如こそが、現在の自動化時代を象徴する「ブラックボックス問題」なのです。技術的な現実は、これらのモデルが人間の知識と偏見の両方を含む「オープンインターネット」で学習されているということです。開発者はデータをフィルタリングしようとしますが、その規模があまりに大きく、完璧な管理は不可能です。私たちがAI倫理について語るとき、実際にはシステムが必然的に生み出すエラーをどう扱うかを議論しているのです。開発のスピードと安全性の必要性の間で、緊張感が高まっています。多くの企業は、市場シェアを失うことを恐れ、十分に理解されないまま製品をリリースするプレッシャーを感じています。その結果、一般の人々が未検証のソフトウェアの「意図しない被験者」となってしまう状況が生まれています。ソフトウェア開発者が、AIが生成した「ハルシネーション(幻覚)」に対して責任を負えるのかどうか、法制度は変化の速さに追いつくのに苦労しています。 新たなグローバル・デジタル・ディバイドこれらのシステムの影響は、世界中で均等に分配されているわけではありません。主要なAI企業の拠点は一部の裕福な国に集中していますが、その影響は世界中で感じられています。グローバルサウスでは、新たな形の労働搾取が浮上しています。ケニアやフィリピンなどの国々では、何千人もの労働者が低賃金でデータのラベル付けやトラウマ的なコンテンツのフィルタリングを行っています。彼らはAIが有害な素材を出力するのを防ぐ「目に見えないセーフティネット」ですが、その利益を享受することはほとんどありません。これは、裕福な国がツールを支配し、発展途上国がそれを維持するための生データと労働力を提供するという権力の不均衡を生んでいます。文化的な支配も、国際社会にとって重要な懸念事項です。ほとんどの大規模モデルは、主に英語のデータと西洋の文化的規範で学習されています。つまり、これらのシステムは、デジタルリソースが少ない言語や地域の文脈を理解できないことが多いのです。これらのツールが輸出されると、現地の知識が均質化された西洋の視点で上書きされるリスクがあります。これは単なる技術的な欠陥ではなく、文化的多様性に対する脅威です。各国政府は、外国のAIインフラに依存することが新たな形の従属を生むことに気づき始めています。自国のAI主権を持たない国は、サービスを提供する企業のルールと価値観に従わざるを得ません。現在、国際社会はいくつかの重要な課題に取り組んでいます:一握りの民間企業への計算能力の集中。水不足の地域における大規模モデル学習の環境コスト。英語中心のモデルに支配されたデジタル空間における、地域言語の浸食。自律型兵器の使用に関する国際合意の欠如。自動化された偽情報が民主的な選挙を不安定にする可能性。 アルゴリズムと共に生きる物流企業のミドルマネージャーであるサラの日常を考えてみましょう。彼女の朝は、AIが生成したメールの要約から始まります。システムは重要と思われるタスクを強調しますが、感情分析ツールが皮肉を認識できなかったため、長年のクライアントからの微妙な不満を見逃してしまいます。その後、彼女は生成AIツールを使って部下の業績評価の下書きを作成します。ソフトウェアは、部下が新人のメンターに費やした時間を考慮せず、生産性指標のみに基づいて低い評価を提案します。サラは、自分の判断を信じるか、機械のデータ主導の推奨を信じるかを選択しなければなりません。もしAIを無視して部下が後に失敗すれば、彼女は「データに従わなかった」と責められるかもしれません。これが、アルゴリズムによる管理がもたらす静かな圧力です。午後、サラは新しい保険に申し込みます。保険会社は自動システムを使用して、彼女のソーシャルメディアと健康記録をスキャンします。システムは、彼女が最近ハイキンググループに参加したことを理由に、アルゴリズムが潜在的な怪我と関連付けているため、彼女を「高リスク」と判定します。対話できる人間はおらず、彼女が健康な経験豊富なハイカーであることを説明する術もありません。保険料は即座に上がります。これは、個人のニュアンスよりも効率を優先するシステムがもたらす現実世界の帰結です。夜になると、サラは記事の半分がボットによって書かれたニュースサイトを閲覧しています。何が事実で、何がクリックを誘うために合成された要約なのかを見分けるのがますます困難になっています。この自動化されたコンテンツへの絶え間ない露出は、彼女の現実認識を変えてしまいます。 BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 テクノロジーはもはや彼女が使うツールではなく、彼女が生きる環境そのものになっています。矛盾は至る所にあります。私たちはAIのスピードを望みながら、その冷たさを恐れています。自動化の利便性を求めながら、人間の主体性の喪失に憤りを感じています。企業は、これらのツールが人間の判断を置き換える能力を過大評価し、偏った出力によって引き起こされる損害を過小評価しています。クリエイターは知的財産権の保護を過大評価し、自分の作品がスクレイパーによっていかに簡単に取り込まれるかを過小評価しています。その結果、私たちは皆、より速く動いているのに、どこへ向かっているのか確信が持てない社会に生きているのです。 効率化の代償私たちは、現在の軌道の隠れたコストについて難しい問いを投げかけなければなりません。AIシステムが企業に数百万ドルの利益をもたらす一方で、1000人の雇用が失われる場合、その社会的コストに責任を負うのは誰でしょうか?私たちは技術の進歩を不可避な自然現象として扱いがちですが、それは特定のインセンティブを持つ個人による特定の選択の結果です。なぜ私たちは労働市場の安定よりも利益の最適化を優先するのでしょうか?また、あらゆるやり取りが学習ポイントとなる時代におけるデータプライバシーの問題もあります。無料のAIアシスタントを使うとき、あなたは顧客ではなく「製品」です。あなたの会話や好みは、最終的にあなたやあなたの雇用主に売り戻されるモデルを洗練させるために使われます。デジタルアシスタントが常に聞き耳を立て、学習しているとき、私的な思考という概念はどうなるのでしょうか?環境への影響も、マーケティング資料ではほとんど語られないコストです。単一の大規模モデルの学習は、数百世帯が1年間に消費する電力に匹敵する可能性があります。データセンターの冷却に必要な水は、乾燥地域の水資源を圧迫しています。私たちは、少しばかり優れたチャットボットのために、生態系の安定を犠牲にする覚悟があるのでしょうか?また、人間の認知への長期的な影響も考慮しなければなりません。執筆、コーディング、批判的思考を機械にアウトソーシングしてしまったら、人間の能力はどうなってしまうのでしょうか?私たちは、デジタルな杖なしでは機能できない人々で溢れた、効率的すぎる世界を築いているのかもしれません。これらは、より多くのデータで解決できる技術的な問題ではありません。私たちがどのような未来に住みたいかという、根本的な問いなのです。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 影響力のインフラパワーユーザーや開発者にとって、倫理的な問いは技術仕様の中に埋め込まれています。ローカルストレージやエッジコンピューティングへの移行は、プライバシー懸念への対応の一環です。モデルをローカルで実行することで、ユーザーは機密データを中央サーバーに送信することを避けられます。しかし、これはハードウェア要件やAPI制限に関する新たな課題を生んでいます。高性能なモデルの多くは、現在不足しているVRAMや特殊なチップを必要とします。これにより、最新のハードウェアを持つ者だけが最も有能なツールにアクセスできるというボトルネックが生じています。開発者も現在のアーキテクチャの限界に苦しんでいます。トランスフォーマーモデルが主流ですが、その中身を検証するのは非常に困難です。重みやアーキテクチャは見えても、なぜ特定の入力が特定の出力につながるのかを簡単に説明することはできません。AIを専門的なワークフローに統合することは、「データポイズニング」や「モデル崩壊」の壁にもぶつかっています。インターネットがAI生成コンテンツで飽和すれば、将来のモデルは前任者の出力で学習することになります。これは品質の低下とエラーの増幅を招きます。これに対抗するため、一部の開発者は検証可能なデータソースや電子透かし技術を模索しています。また、ユーザーがリスクを理解できるように、より透明性の高いAI倫理分析を求める声も高まっています。技術コミュニティは現在、いくつかの主要な開発分野に注力しています:学習セット内の個々のデータポイントを保護するための差分プライバシーの実装。消費者向けハードウェアで実行可能な、より小さく効率的なモデルの開発。偏見や事実誤認を検出するための標準化されたベンチマークの作成。複数の分散デバイス間でモデルを学習させるフェデレーション学習の活用。標準的なニューラルネットワークよりも優れた解釈性を提供する新しいアーキテクチャの探求。 未解決の進むべき道人工知能の急速な進化は、それを管理する私たちの能力を追い越してしまいました。私たちは現在、イノベーションへの欲求と保護の必要性との間で膠着状態にあります。最大の倫理的問いは、機械の能力ではなく、それを制御する人々の意図にあります。 2027 に向けて、焦点はモデルそのものから、データサプライチェーンと開発者の説明責任へと移っていくでしょう。私たちは、今後10年を決定づける問いを突きつけられています。問題を解決するほど強力でありながら、信頼できるほど透明性の高いシステムを構築できるでしょうか?答えはまだコードには書かれていません。それは法廷、会議室、そして利便性と引き換えに自分の自律性をどれだけ差し出すかを決断しなければならない、日常のユーザーの選択によって決まるのです。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。
  • | | | |

    AIの未来を左右する、今注目の裁判の行方 2027

    現在、連邦裁判所で進行中の法廷闘争は、単なる金銭やライセンス料の問題ではありません。それは、生成AIモデルの時代において「創造する」とはどういうことかを定義するための、根本的な戦いなのです。長年、テック企業はほとんど抵抗を受けることなくオープンウェブ上のデータをスクレイピングし、その圧倒的な規模が事実上の免責特権を与えてくれると信じてきました。しかし、その時代は終わりました。ニューヨークとカリフォルニアの裁判官たちは今、機械が教科書から学ぶ人間のように著作権で保護された素材から学習できるのか、それともこれらのモデルは単なる高速な盗作エンジンに過ぎないのかという難問に直面しています。この判決は、今後10年間のインターネットの経済構造を決定づけるでしょう。もし裁判所が学習を「トランスフォーマティブ(変革的)な利用」と認めれば、現在の急速な開発の軌道は続きます。一方で、すべてのデータポイントに対して明示的な許可が必要だと判断されれば、大規模システム構築のコストは跳ね上がるはずです。これはファイル共有の黎明期以来、最も重要な法的緊張状態であり、その賭け金は人類の知識と表現の根幹そのものなのです。 フェアユースの境界線を定義するほぼすべての主要な訴訟の中心にあるのは「フェアユース」の原則です。この法的原則は、批評、報道、研究など特定の条件下において、許可なく著作物を利用することを認めるものです。テック企業は、自社のモデルは元の作品のコピーを保存しているわけではないと主張しています。代わりに、言葉やピクセルの間の数学的関係を学習し、全く新しいものを生み出しているのだと説明します。これが業界で言うところの「トランスフォーマティブな利用」です。彼らは、検索エンジンが元のコンテンツを置き換えるのではなく新しいサービスを提供したとしてウェブサイトのインデックス作成を認められた過去の判決を引き合いに出します。しかし、主要な報道機関やアーティスト団体を含む原告側は、生成AIシステムはそれらとは異なると反論しています。彼らは、これらのモデルが学習元となった人々と直接競合するように設計されていると主張します。ユーザーがAIに特定の現役作家のスタイルで物語を書くよう求めれば、モデルはその作家の生涯の仕事を使い、将来の収入を奪う可能性があるからです。これらの裁判における手続き上のステップは、最終判決と同じくらい重要です。裁判官が訴訟の是非を判断する前に、却下の申し立てや証拠開示請求(ディスカバリー)について裁定を下さなければなりません。この初期段階により、テック企業は使用したデータと処理方法を正確に開示せざるを得なくなります。多くの企業は競争上の優位性を理由に学習セットを秘密にしてきましたが、裁判所はその秘密を剥ぎ取ろうとしています。たとえ最終的に示談になったとしても、証拠開示フェーズで公開された情報は、将来の規制のロードマップとなるでしょう。今、立証責任がクリエイターからテックジャイアントへと移るシフトが起きています。裁判所はAIの最終出力だけでなく、データ取り込みのパイプライン全体を精査しています。これには、データがどのようにスクレイピングされ、どこに保存され、その過程でデジタル著作権管理(DRM)ツールが回避されたかどうかも含まれます。これらの技術的な詳細が、業界全体の新しい法的基準の基礎となるのです。 データ権をめぐる国際的な乖離米国の裁判所がフェアユースに焦点を当てる一方で、世界の他の地域は異なる道を歩んでおり、グローバルなテック企業にとって断片化した法環境を生み出しています。欧州連合(EU)の「AI法」は、厳格な透明性要件を導入しました。これは、学習がどこで行われたかに関わらず、学習に使用された著作物を開示することを企業に義務付けるものです。これは、事後の訴訟に依存する米国システムとは対照的です。EUのアプローチは先制的であり、モデルが公開される前に著作権侵害を防ぐことを目指しています。この哲学の違いは、サンフランシスコで合法的に運用できるモデルが、ベルリンでは展開できない可能性があることを意味します。グローバルなユーザーにとって、利用可能な機能が地域ごとのデータ主権の解釈に依存するようになるということです。一部の国では、地元のイノベーションを促進するためにAI学習を特別に許可する「テキストおよびデータマイニング」の例外を検討している一方で、国家の文化遺産を守るために国境を締め付けている国もあります。イノベーションのスピードと所有権の間の緊張は、国境を越えて事業を展開する企業にとって最も深刻です。もし英国の裁判所がスクレイピングはデータベース権の侵害であると判決を下せば、企業はサービスをジオフェンシング(地域制限)するか、英国市民のデータをモデルから削除しなければならないかもしれません。これは理論上の問題ではありません。すでに各国でプライバシー懸念を理由に特定のツールが一時的に禁止される事態が発生しています。これらの裁判の法的枠組みは、データがどのように流れるかという現実を無視しがちです。一度モデルが学習されると、システム全体をゼロから再学習させずに特定の情報を「忘れさせる」ことはほぼ不可能です。この技術的な限界が、裁判所の決定をより重大なものにしています。一つの判決が、数十億ドル規模の製品を破壊するよう企業に強制することさえあり得るのです。これが、多くの企業が主要な出版社とライセンス契約を急いでいる理由です。彼らは、完全な曖昧さの時代において、法的な確実性を買おうとしているのです。 コードと創造性の摩擦実務上のリスクを理解するために、プロのイラストレーターであるサラの例を考えてみましょう。彼女は15年間、伝統的な水彩画の技法と現代的なデジタルテクスチャを組み合わせた独自のスタイルを築いてきました。ある朝、彼女は自分の名前をプロンプトに入力するだけで、その正確なスタイルで画像を生成できる新しいAIツールを発見します。クライアントは、数セントで「サラ風」の画像が手に入るのに、なぜ彼女に高い料金を払う必要があるのかと問い始めます。これが多くの読者が抱く混乱です。彼らは法律がすでにサラを守っていると考えがちですが、実際はそうではありません。著作権は「特定の作品」を保護するものであり、一般的なスタイルや「雰囲気」を保護するものではないからです。現在の裁判は、このギャップを埋めようとしています。サラは一枚の画像のために戦っているのではなく、自分のプロとしてのアイデンティティをコントロールする権利のために戦っているのです。ここが、この議論が現実味を帯びる場所です。これは抽象的なコードの話ではなく、機械がその人の経験を一度も経ることなく出力を模倣できるようになったとき、人間がいかにして生計を立てるかという問題なのです。ビジネスへの影響は芸術分野にとどまりません。ソフトウェア開発者も、コードアシスタントをめぐって同様の危機に直面しています。これらのツールは数十億行の公開コードで学習されており、その多くは帰属表示(アトリビューション)を義務付けるライセンスの下にあります。AIが開発者にコードブロックを提案するとき、その帰属表示が削除されることがよくあります。これは、これらのツールを使用する企業にとって法的な地雷原となります。開発者が知らぬ間に著作権で保護されたコードを自社製品に挿入してしまい、将来的に莫大な賠償責任を負う可能性があるのです。著作権汚染のリスクは、今や企業法務部門の最優先事項です。一部の企業は、裁判所が明確な指針を示すまで、生成AIを本番コードに使用することを禁止するほどです。彼らは、ツールを使用したことで会社を潰しかねない訴訟に巻き込まれないという確証を待っているのです。この慎重さが、本来なら生産性を高めるはずだったツールの導入を遅らせています。BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 即時の効率化という約束は、法的リスクという現実によって抑制されているのです。 OpenAIとMicrosoftに対するニューヨーク・タイムズの訴訟は、この対立の典型例です。タイムズ側は、AIモデルが記事の段落全体をほぼそのまま再現できると主張しています。これはジャーナリズムの生命線であるサブスクリプションモデルを損なうものです。ユーザーがチャットボットから深い調査報道の要約を得られるなら、元のウェブサイトを訪れる理由がなくなります。OpenAIは、この「反芻」は機能ではなくバグであり、修正に取り組んでいると反論しています。しかし、タイムズにとって損害はすでに発生しています。学習プロセスそのものが侵害だというのです。この裁判は、著作権法の根本目的に触れるため、最高裁まで争われる可能性が高いでしょう。法律は人間による新しい作品の創造を奨励するために存在するのか、それともそれらの作品を利用する新しい技術の開発を促進するために存在するのか。簡単な答えはなく、どちらの決定も一方を裏切る結果となるでしょう。 所有権と同意をめぐる未解決の問いこの状況にソクラテス的な懐疑論を当てはめると、裁判所が対処しきれない深い問題が浮かび上がります。もしモデルが人類の集合的な成果で学習されているなら、その結果を真に所有するのは誰でしょうか?私たちは、印刷機やラジオ放送のために作られた現在の法的枠組みが、統計レベルで動作するシステムを統治できるのかを問わなければなりません。少数の巨大企業が世界のデータを摂取することを許す隠れたコストは何でしょうか?もしクリエイターにデータの完全なコントロール権を与えたら、最も裕福な企業しかAIを構築できない「許可文化」を生み出すリスクはないでしょうか?これは、ライセンス要件の藪の中でイノベーションが窒息する未来につながるかもしれません。逆に、自由なスクレイピングを許せば、モデルが機能するために必要な高品質なデータを作るインセンティブを破壊してしまうのではないでしょうか?システムは最終的に、最高の貢献者たちを廃業に追い込むことで、自らを飢えさせることになるかもしれません。また、著作権議論の中に埋もれがちなプライバシーへの影響も考慮しなければなりません。学習データには、本来公開を意図していなかった個人情報が含まれていることがよくあります。裁判所が著作権の目的でスクレイピングを合法と判断したとき、それは意図せずして個人情報の大量収集にゴーサインを出したことにならないでしょうか?法制度はこれらの問題を別々の箱に入れがちですが、AIの世界ではそれらは密接に結びついています。この技術の核心には、深刻な「同意の欠如」があります。多くの人は、ブログ投稿や写真を投稿することで、いつか自分を置き換えるかもしれない商用製品に貢献しているとは気づいていませんでした。裁判所は、すでに起こってしまったプロセスに対して、遡及的に同意を適用するよう求められています。これはどの裁判官にとっても難しい立場です。彼らは、時速100マイルで走る車のエンジンを、走りながら修理しようとしているのです。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 技術的な緩和策とローカル展開パワーユーザーや開発者にとって、法的な不確実性はローカルストレージや主権モデルへの関心の高まりにつながっています。クラウドプロバイダーが法律を遵守し続けると信頼できないなら、モデルをローカルで実行するのが論理的なステップです。これにより、データ保持やAPI制限に関する懸念の多くを回避できます。現代のワークフローでは、モデルをユーザー自身のプライベートデータに根ざさせるために、RAG(検索拡張生成)の統合が進んでいます。この手法により、モデルは応答を生成する前にローカルデータベースで情報を検索できるため、出力が一般的な学習セットの曖昧な深淵ではなく、検証済み、ライセンス済み、または個人的なソースに基づいていることを保証できます。このローカル実行へのシフトは、中央集権型AIの法的およびプライバシーリスクに対する直接的な反応です。これにより、すべてのデータの出所が把握され、文書化された、より制御された環境が可能になります。API制限やデータポリシーも、法的な環境の変化に応じて変わっています。多くのプロバイダーは、エンタープライズクライアント向けに「データ保持ゼロ」のプランを提供し、データがモデルの将来のバージョンの学習に使用されないことを約束しています。しかし、これらのプランには多くの場合、かなりの価格プレミアムが上乗せされます。法的なコンプライアンスのコストは、ユーザーに直接転嫁されているのです。開発者はまた、モデルの「吐き出し(disgorgement)」という複雑な世界を乗り切らなければなりません。これは、違法に入手したデータで学習されたモデルを削除するよう裁判所が命じる法的救済措置です。特定のAPIの上にビジネス全体を構築した開発者にとって、そのモデルが突然消滅する脅威は壊滅的なリスクです。これを緩和するために、多くの人がLlama 3のようなオープンウェイトモデルに注目しています。これはプライベートインフラでホストできるため、プロプライエタリなAPIにはない安定性を提供します。AI界のギークなセクションは、もはやベンチマークやトークンだけの話ではありません。裁判での敗北を生き延びることができる、強靭なシステムを構築することなのです。OllamaやLM Studioによるローカルモデル展開でデータプライバシーを確保。RAGパイプラインの実装により、一般的な学習データへの依存を低減。API利用規約の変更を監視し、データ使用権の変化に対応。オープンウェイトモデルへの移行により、モデル削除のリスクを回避。PineconeやMilvusのようなベクトルデータベースを使用して独自情報を管理。 未来のイノベーションへの評決これらの裁判の解決は一晩では起こりません。数年にわたる控訴や、議会による新たな法整備が必要になるでしょう。その間、業界はハイブリッドモデルへと移行しています。大手テック企業は、学習パイプラインを確保するために、ニューヨーク・タイムズのような「レガシー」メディア企業と大規模な契約を結び続けるでしょう。小規模なクリエイターは、集団訴訟やスクレイピングを「オプトアウト」するための新しい技術基準に頼らざるを得なくなるはずです。米国著作権局は現在これらの問題を調査しており、その勧告は将来の判決に大きな影響を与えるでしょう。一方、欧州議会は独自のルールを洗練させ続けており、これが透明性に関する世界標準を強制することになります。「何が公正か」という混乱は、やがてマイクロペイメントと自動ライセンスの複雑なシステムに取って代わられるでしょう。 最終的な結論は、AIの「西部開拓時代」は終わったということです。私たちは、道路のルールがリアルタイムで書かれている制度化の時代に突入しています。企業や個人にとっての最善の戦略は、AIに関する進化する法的基準について常に情報を得て、技術スタックに柔軟性を持たせることです。イノベーションのスピードと所有者の権利の間の緊張は、解決すべき問題ではなく、管理すべきバランスです。この摩擦を乗りこなせる者こそが、デジタル時代の次のフェーズで成功するでしょう。裁判所は境界線を提供しますが、その中で何を構築したいかを決めるのは私たち自身です。AIの未来は単なる技術的な問題ではなく、公平性と財産という私たちの古くからの概念に根ざした、深く人間的な問題なのです。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。
  • | |

    驚異のAIデモ、その裏側にある真実とは?

    5分間のプレゼンに隠された高いハードル洗練されたテックデモは、現代の象徴です。プレゼンターがコンピュータに話しかけると、コンピュータが人間のようなウィットで返答する。たった一行のプロンプトから、まるで大作映画のような映像が生成される。こうした演出は、見る者に畏敬の念を抱かせるために計算し尽くされています。資金を調達し、世間の注目を集めるための緻密なパフォーマンスなのです。しかし、一般ユーザーにとって、ステージ上のデモと実際に製品として出荷されるものとの間には、深い溝があります。デモは「完璧な条件下で結果が出せること」を証明するだけで、「日常の雑多な現実でも使えること」を証明するものではありません。私たちは今、実際に何ができるかという実用性よりも、何ができそうかというスペクタクルが先行する時代を生きています。これがハイプ(誇大広告)のサイクルを生み、熟練の観察者でさえ本質を見極めるのを困難にしています。真の進歩を理解するには、映画のような照明や台本通りのやり取りの裏側を見る必要があります。カメラが止まり、標準的なインターネット環境でコードが動かされたとき、何が起きるのかを問いかけるべきなのです。 合成された完璧さの裏側最新のAIデモは、ハイエンドなハードウェアと膨大な人間による準備の組み合わせに依存しています。企業がリアルタイムでモデルが対話する様子を見せる際、そこには一般人が決してアクセスできないような特殊なチップのクラスターが使われていることがよくあります。また、モデルが脱線しないようにプロンプトエンジニアリングといった手法も駆使されます。デモは、いわば「ハイライト映像」です。開発者は、画面に映る完璧な回答を一つ引き出すために、同じプロンプトを50回も試しているかもしれません。これは必ずしも詐欺的ではありませんが、特定の種類のストーリーテリングなのです。MIT Technology Reviewの報告によると、動画で見られるレイテンシ(遅延)は、編集でカットされていることがよくあります。ライブ環境では、複雑なリクエストを処理するのに数秒かかるモデルでも、デモではその間が削除され、流暢に動いているように見せかけます。これが、実際の使用感に対する誤った期待を生むのです。もう一つの常套手段は、パラメータを狭めることです。例えば、帽子をかぶった猫の動画生成に特化した学習データを使えば、その分野では素晴らしい成果を出せます。しかし、ユーザーがより複雑な生成を試みると、システムは途端に行き詰まります。デモは特定のタスクに最適化された製品を見せていますが、実際のツールはもっと制限されていることが多いのです。デモ自体が製品化され、利用可能なサービスのプレビューというよりは、マーケティングツールとして機能するようになっています。その結果、消費者は新しいプラットフォームに登録する際、実際に何を買わされているのかを判断するのが難しくなっています。 バイラル動画の地政学これらのデモの影響は、テックコミュニティを遥かに超えています。今や世界規模で「ソフトパワー」の一種となっています。国家や巨大企業は、AI分野での優位性を示すためにこれらのショーケースを利用します。米国の主要企業が新しい生成AIツールのバイラル動画を公開すれば、欧州やアジアの競合他社が即座に反応します。これにより、安定性よりもスピードが優先される競争が生まれます。投資家は、数分間の印象的な映像を根拠に、何十億ドルもの資金を企業に注ぎ込みます。これは、企業の評価額が実際の収益や製品の成熟度と乖離する「市場バブル」を招く恐れがあります。The Vergeが指摘するように、このパフォーマンスへの圧力は倫理的な近道を生む可能性があります。企業は、まだ安全でも信頼性も高くないモデルのデモを急いでリリースするかもしれません。世界中のオーディエンスは、数ヶ月ごとに魔法のようなブレイクスルーを期待するように条件付けられています。これは、パフォーマンスを安定したソフトウェアに変えようと奮闘する研究者やエンジニアに多大な負荷をかけています。過去には、デモによって株価が急騰したものの、実際の製品が期待外れで株価が暴落するケースが何度も見られました。このボラティリティは世界経済全体に影響を与え、ベンチャーキャピタルの流れやスタートアップの生存率を左右します。バイラルデモは、テック政策や投資を動かす主要な原動力となっており、今日の世界で最も影響力のあるメディアの一つです。政府が労働の未来や国家安全保障をどう捉えるかさえ、形作っているのです。 プロトタイプの影で生きる小さな広告代理店で働くマーケティングマネージャー、サラの例を考えてみましょう。彼女は、高品質な広告を数秒で作成できるという新しい生成動画ツールのデモを見ました。デモでは、ユーザーが簡単なプロンプトを入力するだけで、完璧な30秒のCMが出来上がります。サラは興奮し、クライアントに「制作予算を削り、納期を短縮できる」と伝えました。彼女はこの新しいテクノロジーで競合に差をつけようと意気込んでいます。しかし、いざベータ版にアクセスしてみると、現実は衝撃的でした。システムは1つのクリップを生成するのに20分もかかり、動画内のキャラクターの顔は歪み、背景の色はランダムに変化します。サラは何時間もかけてエラーを修正しようとしましたが、結局、最初からプロの編集者に依頼した方が早かったと気づくのです。これこそが「デモの溝(demo gap)」の正体です。サラのような話は、これらのツールを日常業務に取り入れようとする専門家の間でよく聞かれます。AI Magazineの最新トレンドが示唆するように、テクノロジーは進化しているものの、ステージで見せられたようなシームレスな解決策にはまだ程遠いのです。 BotNews.today は、AIツールを使用してコンテンツの調査、執筆、編集、翻訳を行っています。 当社のチームは、情報が有用で明確、信頼できるものであるよう、プロセスをレビューし監督しています。 ユーザーは、自分でタスクをこなすよりも、AIの管理に多くの時間を費やしていることに気づきます。これはフラストレーションと燃え尽き症候群につながります。デモが設定したハードルに、現在のソフトウェアは届いていないのです。なぜこのようなことが起きるのか、デモがどのように演出されているかを知る必要があります。デモでは、リアルタイム生成ではなく、プロンプトによってトリガーされる事前レンダリングされた素材が使われることが多い。ステージプレゼンで使用されるハードウェアは、一般公開されるクラウドサーバーよりも遥かに強力であることが多い。台本通りのやり取りは、実際の使用で発生するエッジケースや「ハルシネーション(幻覚)」を回避している。モデルの出力が公開される前に、裏で人間のモデレーターがフィルタリングや修正を行うことがある。ユーザーが受ける結果は、欺かれたという感覚です。ツールが宣伝通りに動かないとき、ユーザーは自分自身やプロンプトのせいにします。デモが慎重に管理された実験であったとは気づきません。これが、本物のブレイクスルーと巧妙なマーケティングの区別がつかない混乱した文化を生んでいます。クリエイターにとって、仕事が予測不可能な形で変化していることを意味します。デモによって自分のスキルが時代遅れだと言われたのに、代わりのツールが信頼できないと知るのです。この不確実性が、将来の計画や新しいスキルへの投資を困難にしています。「驚き」ばかりに焦点を当てることは、毎日これらのツールを使う人々の実用的なニーズを無視することに他なりません。 推論という不都合な計算こうした印象的なディスプレイの背後にある隠れたコストについて、難しい問いを投げかける必要があります。モデルが高品質な画像や動画を生成するたびに、膨大なエネルギーが消費されます。デモのカーボンフットプリント(二酸化炭素排出量)について語られることは稀です。データセンターの電力需要は急増しており、その大部分はこうした複雑なモデルを動かす必要性に起因しています。Wiredによると、たった一つのバイラルデモの環境コストは、数百世帯のエネルギー使用量に匹敵する可能性があります。データプライバシーの問題もあります。モデルの学習データはどこから来たのでしょうか?最も印象的なデモの多くは、著作権物や個人情報を含むデータセットに基づいて構築されており、元の作成者の同意を得ていません。これは企業が無視しようとしている法的・倫理的な地雷原です。また、「推論(inference)」のコストも考慮しなければなりません。これらのモデルを大規模に実行するのは非常に高コストです。デモを披露している企業のほとんどは、クエリごとに赤字を出しています。これは持続可能なビジネスモデルではありません。つまり、ツールが完全にリリースされた後には、非常に高額になるか、品質が大幅に低下するかのどちらかでしょう。なぜデモはこうした制限を隠すのでしょうか?答えは通常、投資家の信頼に関係しています。もし企業が「一般公開するにはコストがかかりすぎる」と認めれば、評価額は暴落するでしょう。私たちは、一般人にとっては経済的に成り立たないかもしれない未来を見せられているのです。また、デモで見せられる「安全性」機能にも懐疑的であるべきです。管理された環境でモデルを安全に見せるのは簡単です。しかし、何百万人ものユーザーの手に渡った後に悪用を防ぐのは遥かに困難です。これらの問題に関する透明性の欠如は、無視できない大きな危険信号です。 AIに関するストーリー、ツール、トレンド、または取り上げるべき質問がありますか? 記事のアイデアをお送りください — ぜひお聞かせください。 アーキテクチャとAPIの限界パワーユーザーや開発者にとって、デモの興奮は技術仕様の現実によって冷やされることがよくあります。最も印象的なモデルは、制限の厳しいAPIの背後にロックされています。これらのインターフェースには厳しいレート制限と高コストがあり、大規模な実装を困難にしています。デモでは1000ページの文書を数秒で処理するモデルを見せられても、実際のAPIでは一度に10ページしかアップロードできないかもしれません。これが「コンテキストウィンドウ」の問題です。モデルの理論上の限界は大きくても、開発者にとっての実際の実用限界は遥かに小さいのです。ローカルストレージや処理の問題もあります。デモで見られるツールのほとんどは、常時接続のインターネットと膨大なクラウドコンピューティング能力を必要とします。これは、オフラインで作業する必要があるユーザーや、厳格なデータセキュリティ要件を持つユーザーにとっては問題です。ローカルLLMは人気が高まっていますが、パフォーマンスの面ではクラウドベースの巨人にはまだ及びません。トップクラスのデモに近い品質のモデルを実行するには、複数のハイエンドGPUを搭載したワークステーションが必要です。これは、ほとんどの個人や中小企業には手が届きません。また、業界の標準化も欠如しています。すべての企業が独自のフォーマットとAPIを持っており、複数のツールを組み合わせたワークフローを構築するのが困難です。AIの「ギーク」な現実は、互換性のないソフトウェアと高価なハードウェアが断片化した風景です。パワーユーザーが現在直面している主な技術的ハードルは以下の通りです。トークン制限により、長文コンテンツや複雑なコードベースを一度に処理できないことが多い。API応答のレイテンシが高いため、リアルタイムのフィードバックが必要なアプリケーションの構築が難しい。トップクラスのモデルの多くで微調整(ファインチューニング)オプションが欠如しており、特定の業界向けにAIをカスタマイズできない。クラウドプロバイダーから大量の生成データを移動する際のデータ転送コストが、すぐに法外な額になる可能性がある。ワークフローの統合は最大の課題です。ほとんどのAIツールは、依然としてスタンドアロンのチャットインターフェースとして設計されています。動画編集ソフト、IDE、プロジェクト管理ツールといった既存のソフトウェアに簡単にプラグインできません。デモではシームレスなやり取りを見せても、実際の実装には壊れやすい複雑な「接着コード」が必要です。人間が介入せずにツール同士が真に会話できる日が来るのを、私たちはまだ待っています。それまでは、パワーユーザーは手動のデータ入力とトラブルシューティングのサイクルから抜け出せません。 映画のようなノイズからシグナルを分離する最も印象的なAIデモは、単なる未来のプレビューではありません。それらは、何が可能かという私たちの認識に影響を与えるために設計された、特定の種類のメディアです。テクノロジーが一定の洗練レベルに達したことは証明しますが、世界に通用する準備ができたことを証明するものではありません。ユーザーや観察者として、私たちはパフォーマンスの「継ぎ目」を探すことを学ぶ必要があります。ハードウェア、コスト、そして5分間の動画を完璧に見せるために費やされた人間の努力について問いかけるべきです。AIの真の進歩は、多くの場合、退屈なアップデートの中にあります。わずかに速くなった推論時間、より安定したAPI、そしてより優れたデータプライバシー管理。これらはバイラル動画にはなりませんが、私たちの働き方や生き方を実際に変えるものです。「驚かされる」時代を過ぎ、信頼性が高く、倫理的で、利用しやすいツールを要求し始める必要があります。デモと製品の間の溝は、いつか埋まるでしょう。しかし、それは私たちがステージ上での約束に対して開発者の責任を追及する場合に限られます。テクノロジーの未来は、少数の手の中でのパフォーマンスではなく、多くの人々の手の中での実用性によって判断されるべきなのです。 編集者注: 当サイトは、コンピューターオタクではないものの、人工知能を理解し、より自信を持って使いこなし、すでに到来している未来を追いかけたいと願う人々のための、多言語対応のAIニュースおよびガイドハブとして作成されました。 エラーを見つけたり、修正が必要な点がありましたか? お知らせください。